

MWS AI (входит в МТС Web Services) выложила в открытый доступ RESON (Research Engine for Speech Observation & Notes) — инструмент для комплексной оценки качества моделей автоматического распознавания речи (ASR). Он позволяет сравнивать модели по более чем 10 метрикам и автоматически формирует интерактивный HTML-отчет с результатами анализа. RESON стал первой открытой разработкой MWS AI в области распознавания речи. Инструмент будет представлен на форуме информационных технологий «Цифровые решения».
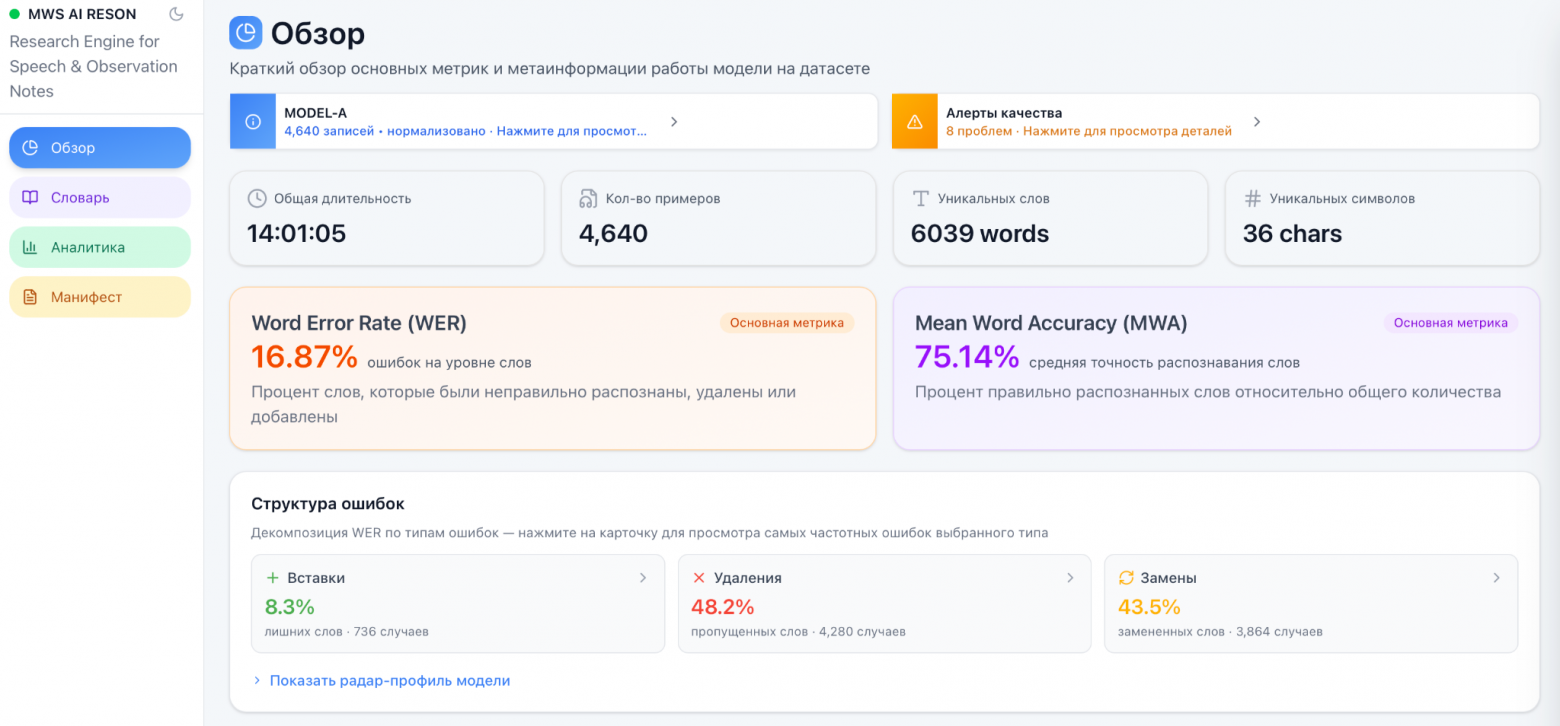
Чтобы проанализировать качество модели с помощью RESON, пользователю необходимо загрузить результаты распознавания модели и эталонные расшифровки. Инструмент позволяет привести тексты к единым правилам, чтобы некритичные различия в написании слов не влияли на итоговую оценку качества, а также проводит анализ по выбранным метрикам и сравнивает результаты. На выходе формируется интерактивный отчёт, который открывается в формате веб-страницы. Его можно использовать для технического анализа и для наглядного представления результатов бизнес-команде.
RESON поддерживает более 10 метрик, которые можно настраивать под свои задачи. В числе доступных, например:
- WER (Word Error Rate) — показывает количество ошибок при распознавании слов;
- CER (Character Error Rate) — рассчитывает ошибки на уровне отдельных символов;
- MWA (Mean Word Accuracy) — дает каждому уникальному слову одинаковый вес и помогает заметить ошибки на словах, которые редко встречаются в данных, например названиях компаний, продуктов или сервисов.
- WIS (Word Importance Score) — разработанный MWS AI показатель, который помогает находить слова, которые почти не влияют на общий результат, но важны для конкретного сценария — например название брендов и продуктов, англицизмы. Он учитывает, как часто встречается слово, насколько плохо оно распознаётся, какие ошибки возникают и на какие варианты модель его заменяет. Это позволяет, в частности, приоритизировать улучшения модели в отраслевых сценариях.
RESON доступен в формате открытой Python-библиотеки. Его можно встроить в существующие процессы разработки через командную строку или Python API и развернуть в собственной инфраструктуре компании, в том числе в закрытом контуре. Инструмент рассчитан на команды, которые сравнивают разные версии моделей и на компании, выбирающие между решениями разных разработчиков.
Новый открытый бенчмарк для оценки моделей MWS RESON ASR OSD
Вместе с RESON MWS AI опубликовала MWS RESON ASR OSD — открытый бенчмарк (набор данных и правил для сравнения моделей в одинаковых условиях) с готовыми русскоязычными аудиоданными для оценки качества моделей распознавания речи. Он включает более 12 тыс. размеченных аудиозаписей общей длительностью около 38 часов и ориентирован в том числе на сценарии голосовой связи и контакт-центров.
В бенчмарке представлены два типа данных: разговорная речь и фразы с числами и числовыми последовательностями. В него входят обращения в поддержку, автоматические уведомления и бытовые звонки, а также телефонные номера, счета, даты, суммы и другие данные. Записи представлены как без выраженных помех, так и с акустическим шумом и фоновой речью — например, звуками телевизора или посторонними голосами. В данных также встречаются англицизмы и названия компаний, банков, операторов связи, цифровых сервисов, устройств и приложений.
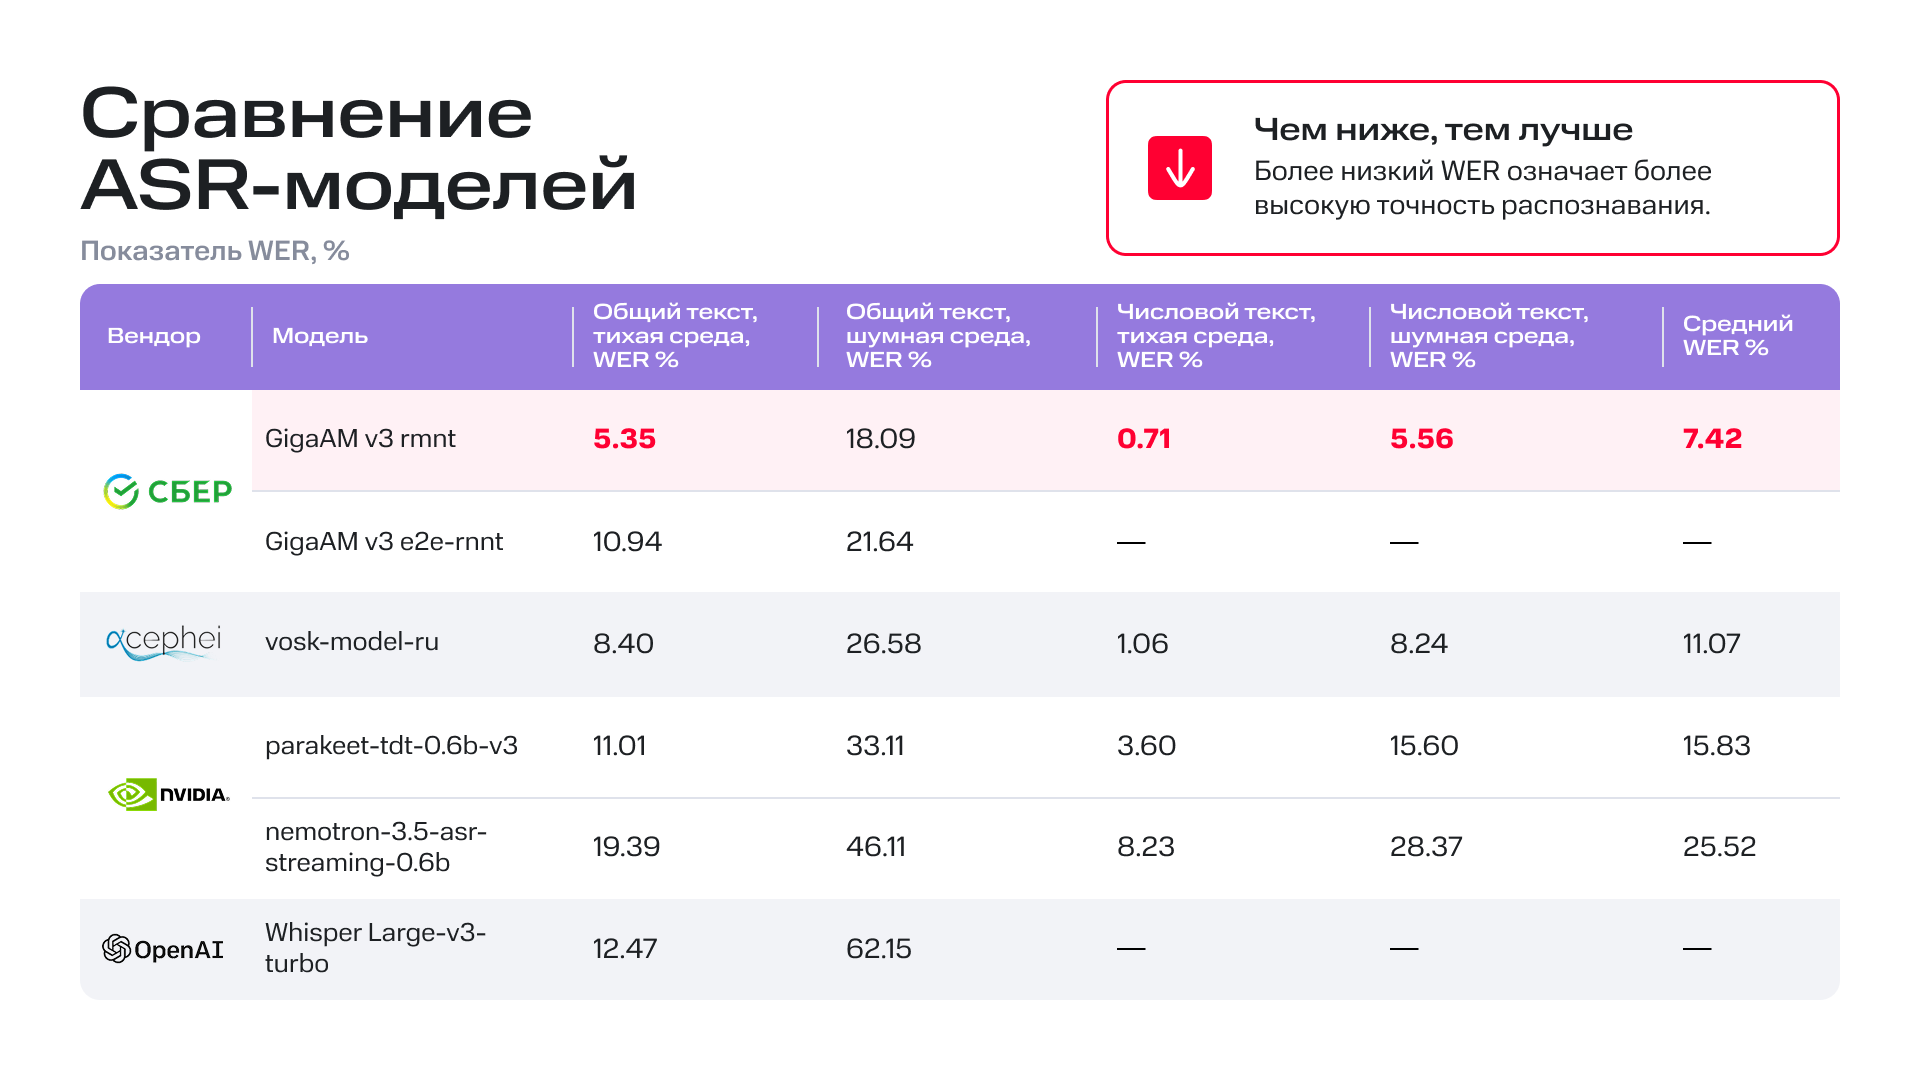
В рамках публикации бенчмарка MWS AI провела замеры качества открытых моделей Сбера, Alpha Cephei, Nvidia и OpenAI. Модели сравнивали по WER — показателю, который отражает количество ошибок при распознавании слов. Среди моделей, протестированных на всех четырех наборах данных, лучший средний результат показала GigaAM v3 от Сбера: средний WER составил 7,42%. У Vosk показатель составил 11,07%, у Nvidia Parakeet — 15,83%, у Nvidia Nemotron — 25,52%. GigaAM допускала более чем вдвое меньше ошибок, чем Nvidia Parakeet, и более чем втрое меньше, чем Nvidia Nemotron. На втором месте по точности другая российская разработка – Vosk от Alpha Cephei.
«RESON изначально создавался для внутренних задач команды. Раньше оценка качества фактически собиралась из нескольких инструментов: отдельно считались метрики, отдельно разбирались ошибки, а результаты приходилось сводить вручную. RESON объединил этот процесс в одной системе — от подготовки данных до сравнения моделей и разбора конкретных ошибок. Анализ, который раньше мог занимать несколько часов, сократился до 10–15 минут. Сейчас мы открываем этот подход индустрии — это наш вклад в формирование общего подхода к оценке ASR-моделей, как минимум на русскоязычных данных».
Александр Шевченко, руководитель команды распознавания речи MWS AI