

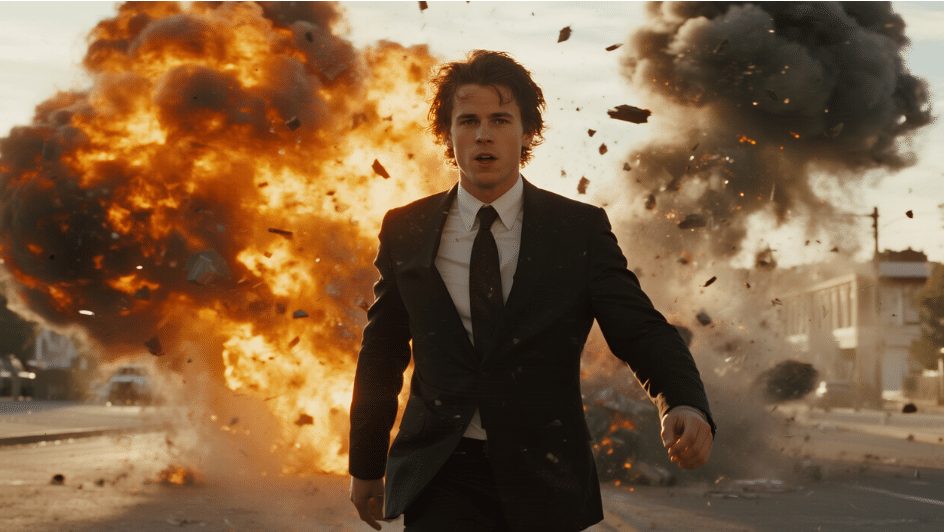
Для генерации достаточно загрузить изображение и аудиодорожку. Модель анализирует не только звучание, но и смысл речи, ее интонации и ритм, чтобы подобрать подходящие движения и эмоциональные реакции. При помощи текстовых подсказок можно дополнительно настраивать действия персонажа, композицию кадра и движения виртуальной камеры.
OmniHuman 2.0 поддерживает сцены с несколькими персонажами: модель может распределять отдельные аудиодорожки между людьми, изображенными в одном кадре, и создавать диалоги или групповые выступления. Ее также можно использовать для музыкальных видео, цифровых ведущих, рекламных роликов и анимации персонажей, включая животных и рисунки.
На странице BytePlus указана цена генерации — 0,07 доллара за секунду видео для OmniHuman 2.0. Компания также заявляет о возможности создавать ролики продолжительностью от 30 секунд до пяти минут и снижении стоимости на 40% по сравнению с предыдущей версией.
OmniHuman доступна через платформу BytePlus и API. Технология может упростить производство видео с виртуальными персонажами, поскольку для создания анимированного выступления не требуется снимать человека на камеру: достаточно подходящего изображения и аудиозаписи.
Читайте также: