
Ученые Центра искусственного интеллекта Новосибирского государственного университета разработали программную платформу «Каппа» для подготовки данных и проверки моделей ИИ. Она позволяет контролировать качество наборов данных, отслеживать изменения и сравнивать результаты работы разных моделей. Университетам предлагают бесплатный доступ к онлайн-версии, а организации могут установить систему на собственных серверах.
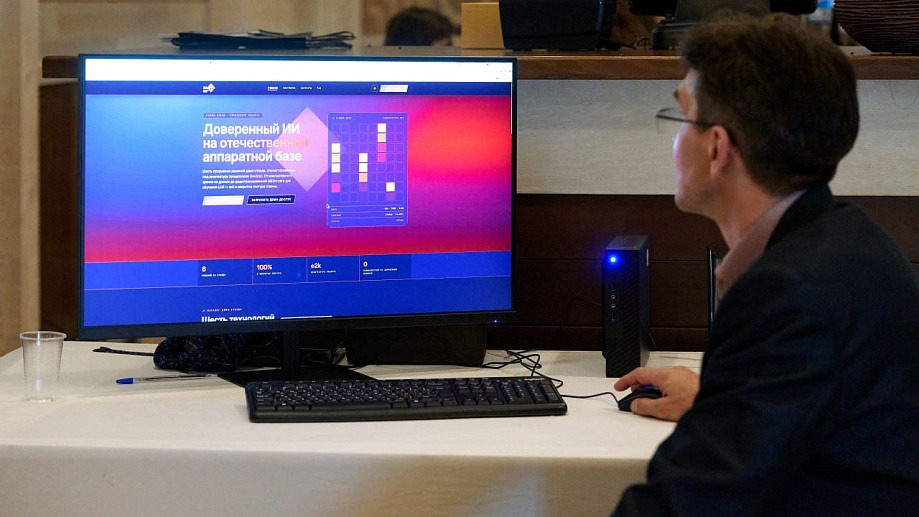
Разработку представили на международном форуме «Открытые данные» в Республике Алтай. С докладом выступил Евгений Павловский, заведующий лабораторией аналитики потоковых данных и машинного обучения НГУ.
Платформа охватывает весь цикл работы с данными для машинного обучения: от формирования и разметки до проверки, сохранения версий и публикации. Она также позволяет тестировать модели на подготовленных наборах данных и отслеживать их работу после внедрения.
Необходимость такого инструмента связана с тем, что ошибки в обучающих данных могут снижать качество нейросетей. При этом заказчику бывает сложно проверить, на какой информации обучалась модель и насколько надежны ее результаты.
«Каппа» фиксирует, кто и когда вносил изменения в датасет. Если обнаруживается ошибка, ее можно исправить и сохранить обновленную версию набора данных. Это помогает воспроизводить эксперименты и использовать проверенные материалы при дальнейшем обучении моделей.
Еще одна возможность платформы — сравнение качества разных алгоритмов на одинаковых наборах данных. Проверять можно как собственные разработки, так и общедоступные модели. После обучения система помогает оценить результаты на эталонных данных, а во время эксплуатации собирает статистику и отслеживает ошибки. При отклонениях она может сигнализировать о необходимости переобучения.
Один из крупнейших проектов на «Каппе» команда НГУ реализовала совместно с Государственной публичной научно-технической библиотекой СО РАН. Библиотека предоставила около 400 тысяч записей, включая оцифрованные карточки и их каталожные расшифровки. В разметке участвовали примерно 100 сотрудников. Платформа отслеживала работу каждого специалиста, а результатом стали обученная модель и контрольный набор данных для проверки других алгоритмов.
Систему также применяли для озвучивания научных книг, паспортизации фасадов и работы с архивными документами. Команда НГУ также разрабатывает набор данных для оценки учебных результатов школьников.
Университет предлагает два варианта использования «Каппы». Онлайн-версия доступна бесплатно после регистрации на сайте. Второй вариант — установка платформы в собственной инфраструктуре организации, чтобы данные не покидали ее серверы.
Команда НГУ готова провести для университетов пилотный проект продолжительностью до 30 дней. За это время специалисты оценят качество имеющихся датасетов, возможность их повторного использования и наличие смещений в данных.
Читайте также:
Anthropic предложила запрет ИИ-моделей только при угрозе ущерба от $1 млрд
ИИ-агенты Google самостоятельно прошли Minecraft за 27 часов