

Искусственный интеллект в российских компаниях развивается стремительно и уже не редкость, а скорее норма. Поддержка, аналитика, разработка, продажи — везде появляются свои сценарии.
Но чем активнее компании используют публичные LLM, тем острее встает вопрос, что именно уходит на сторону, когда сотрудник вставляет текст в окно чат-бота. По оценке Harmonic Security, около 12% данных, которые сотрудники отправляют в публичные AI-сервисы, могут содержать конфиденциальную бизнес-информацию. Более 20% загруженных файлов в AI-инструментах содержат чувствительные данные.
В статье разбираем, какие данные нельзя отправлять в публичные нейросети и как выстроить безопасную работу с моделями.
 Что происходит с данными при работе с публичными нейросетями
Когда сотрудник отправляет запрос, данные уходят на серверы поставщика, который может находиться в другой юрисдикции. Искусственный интеллект как сервис удобен тем, что не нужно разворачивать инфраструктуру, платить за GPU и нанимать команду. Но у этой модели есть обратная сторона, которая заключается в том, что компания теряет контроль над тем, что происходит с отправленными данными.
При работе с публичными AI-сервисами компания передает данные за пределы собственного контура и должна учитывать правила конкретного провайдера: где обрабатываются данные, как долго они хранятся, используются ли для улучшения моделей, какие субподрядчики участвуют в обработке и какие настройки приватности доступны. Интеграция искусственного интеллекта в бизнес без понимания этого риска превращается в постоянную утечку.
Какие данные нельзя отправлять в нейросети
Даже файл, который выглядит безобидно, может нести больше, чем видно на экране. Документы Word сохраняют имена авторов, историю правок и комментарии, если их специально не удалить. Фотографии с телефона содержат GPS-координаты места съемки. В таблицах могут остаться скрытые листы, а в отсканированной форме — чужие реквизиты в углу, который не обрезали.
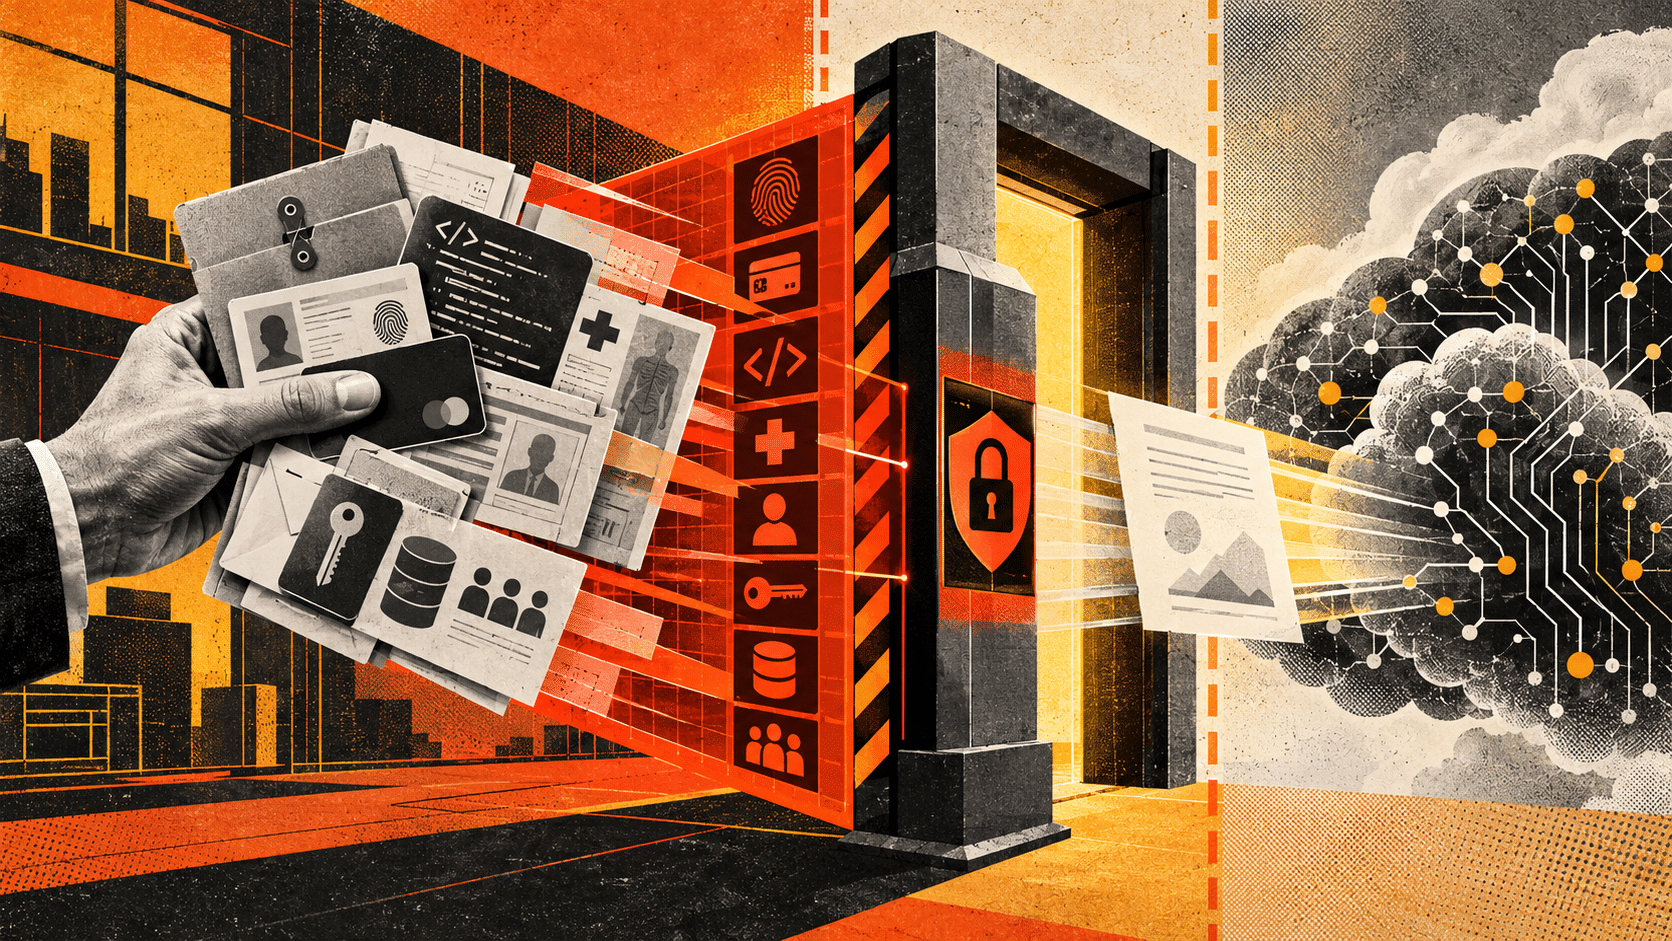
Список категорий, которые не стоит передавать в публичные нейросети, шире, чем кажется на первый взгляд:
- Персональные данные. ФИО, паспортные данные, номера телефонов, адреса, даты рождения, номера банковских карт, СНИЛС, ИНН физических лиц. Персональные данные нельзя передавать во внешний AI-сервис без проверки правовых оснований и условий такой обработки. Для российских компаний дополнительно необходимо учитывать требования 152-ФЗ, включая требования к локализации и, при наличии трансграничной передачи, соответствующие правила ее осуществления. Внедрение искусственного интеллекта в компанию должно начинаться с четкого понимания, какие персональные данные вообще есть в обороте.
- Медицинские данные. Диагнозы, результаты анализов, история болезни, назначения. Сведения о состоянии здоровья относятся к специальным категориям персональных данных.
- Банковская, финансовая и иная чувствительная финансовая информация. Реквизиты счетов, банковские выписки, сведения о транзакциях, кредитные данные и непубличная финансовая отчетность.
- Коммерчески чувствительная информация. Договоры и условия сделок, цены, себестоимость, планы развития, маркетинговые стратегии, клиентские базы. Если в отношении таких сведений установлен режим коммерческой тайны, их передача во внешний AI-сервис должна соответствовать установленным правилам доступа и конфиденциальности.
- Внутренняя переписка и документы. Письма сотрудников, протоколы совещаний, внутренние регламенты, черновики, кадровые документы.
- Исходный код и техническая документация. Проприетарный код, архитектурные схемы, конфигурации, ключи доступа, описания уязвимостей.
- Данные клиентов и партнеров. Все, что компания получила от третьих лиц и обязалась защищать по договору.
- Государственная тайна и служебная информация. Данные ограниченного доступа, сведения о критической инфраструктуре, информация о безопасности.
- Биометрические данные. Отпечатки пальцев, сканы лица, голосовые слепки.
- Информация, защищенная специальными режимами конфиденциальности. Например, сведения, составляющие адвокатскую тайну, отдельные материалы судебных процессов и документы, доступ к которым ограничен законом или договором.
Отдельная категория риска — данные других людей. Кадровые документы, переписка коллег, реквизиты партнеров, клиентские базы. Даже если у вас есть право читать этот документ, это не значит, что у вас есть право передавать его третьим лицам. Договор под NDA не перестает быть конфиденциальным от того, что вы загрузили его в чат-бот.
Что происходит, если данные все-таки ушли
Удаление чата не всегда означает немедленное физическое удаление всех связанных данных. Сроки хранения зависят от конкретного AI-сервиса, типа аккаунта, API или пользовательского режима и настроек хранения. Поэтому перед передачей корпоративных данных важно заранее проверить политику хранения данных провайдера.
Последствия не всегда очевидны сразу. Искусственный интеллект в управлении бизнес-процессами может годами работать без инцидентов, пока однажды не выяснится, что часть данных могла сохраниться в журналах сервиса или, в зависимости от политики конкретного провайдера и настроек аккаунта, использоваться для улучшения моделей.
Среди типичных рисков безответственного использования ИИ:
- Утечка коммерческой информации к конкурентам или третьим лицам.
- Нарушение 152-ФЗ. Штрафы, предписания регулятора, приостановка обработки данных.
- Репутационный ущерб. Клиенты и партнеры узнают, что их данные передавались наружу.
- Ограниченные возможности отзыва данных. После передачи информации внешнему сервису компания уже не контролирует весь жизненный цикл данных и должна учитывать правила хранения, удаления и использования, установленные провайдером.
- Юридические претензии от клиентов, сотрудников, контрагентов.
Инструмент для автоматизации не должен оборачиваться новыми рисками. Но именно так происходит, когда сотрудники используют публичные чат-боты в обход корпоративных правил.
Почему сотрудники все равно отправляют данные
Запрет без объяснения не работает. Если ИИ-услуги для бизнеса недоступны внутри компании, сотрудники найдут обходной путь, будь то личный аккаунт, личный ноутбук, личный мессенджер. Нейросети для управления проектами и другие инструменты кажутся безобидными, и сотрудник не думает, что вставленный договор — это утечка. Причины просты:
- Нет корпоративного инструмента, который решает задачу так же удобно.
- Нет понятных правил, что можно, что нельзя, почему.
- Нет обучения. Сотрудники не знают, какие данные считаются чувствительными.
- Нет контроля. Никто не проверяет, что уходит в публичные сервисы.
Как выстроить безопасную работу с нейросетями
Шаг 1. Инвентаризация
Соберите список приложений и сервисов, которые уже используют LLM. Выясните, какие данные туда уходят, кто владелец, какие ключи и договоры.
Шаг 2. Классификация данных
Определите, какие категории данных есть в компании и какие из них допустимо передавать во внешние модели. Зафиксируйте это в политике.
Шаг 3. Правила и обучение
Объясните сотрудникам, что можно, что нельзя и почему. Не просто запрет, а понятные примеры: «договор нельзя, а обезличенную выдержку — можно».
Шаг 4. Корпоративный шлюз
При выборе AI-сервиса важно проверить, где обрабатываются и хранятся данные, используются ли запросы для обучения моделей, а также какие доступны механизмы DLP, аудита и управления доступом.
Единый LLM API-шлюз позволяет централизовать доступ к моделям, а при наличии соответствующих механизмов на уровне шлюза — применять DLP, маскирование данных, политики блокировки и маршрутизацию запросов.
Шаг 5. Внутренний контур для чувствительных задач
Для данных, которые нельзя передавать внешнему AI-провайдеру, используют внутренний или изолированный AI-контур — например, собственную инфраструктуру, выделенный GPU-контур или Private AI Cloud. В таком контуре можно размещать модели, которые допускают локальное развертывание. Тогда искусственный интеллект в бизнесе работает и с закрытой информацией. Такой сценарий можно реализовать и через управляемый сервис. Один из вариантов такой архитектуры — управляемый AIaaS: единый OpenAI-совместимый API-шлюз, через который можно централизовать доступ к моделям, применять политики обработки данных и разделять внешние и внутренние маршруты. Например, такую архитектуру реализует AIaaS ITGLOBAL.COM, а для данных, которым нужна изоляция, — Private AI Cloud на выделенном GPU-контуре.
Шаг 6. Контроль и аудит
Логируйте, кто и какие модели использует, сколько токенов тратит, какие запросы блокируются. Это дает понимание реальной картины и помогает улучшать правила.
Какой подход выбрать
| Сценарий | Пример данных | Подход |
| Открытая информация | Публичные тексты, общедоступные документы | Публичная нейросеть |
| Черновики и некритичные задачи | Тексты без чувствительных данных | Публичная нейросеть при соблюдении политики компании |
| Рабочие данные | Внутренние документы без ПДн и критичной информации | Корпоративный AI-шлюз |
| Персональные данные | Клиентские и кадровые данные | Корпоративный контур с контролем обработки |
| Коммерчески чувствительная информация | Договоры, цены, стратегии | Корпоративный AI-шлюз или изолированный контур |
| Критичные или специально защищаемые данные | Данные с особыми требованиями к режиму доступа | Изолированный внутренний контур |
Отдельно стоит смотреть на то, где физически обрабатываются запросы — для российских компаний это часто решающий фактор. Если данные должны оставаться в контуре, подойдет управляемый сервис с российским ЦОД. В AIaaS от ITGLOBAL.COM приложения подключаются к единому API в формате OpenAI, а доступ к моделям регулируется ключами, ролями, квотами и бюджетами. При этом содержимое запросов и ответов в журнале не сохраняется.
Перед отправкой данных в нейросеть проверьте себя по чек-листу:
- Есть ли в документе персональные данные?
- Есть ли банковские или платежные данные?
- Содержит ли файл коммерчески чувствительную информацию?
- Есть ли сведения о клиентах или партнерах?
- Есть ли API-ключи, пароли, токены или конфигурации?
- Есть ли исходный код или информация об уязвимостях?
- Разрешена ли передача такого типа данных политикой компании?
- Известно ли, где обрабатываются данные?
- Известно ли, сколько времени сервис их хранит?
- Разрешено ли провайдеру использовать данные для улучшения моделей?
- Можно ли решить задачу на обезличенных данных?
Выводы
Публичная нейросеть — это не хранилище. Относиться к каждому загруженному файлу стоит с той же осторожностью, с какой вы бы отправили его незнакомому человеку по электронной почте.
Искусственный интеллект в российских компаниях уже стал частью повседневной работы, но его использование без понимания границ допустимого — это риск, который может проявиться в самый неподходящий момент.
Публичные нейросети удобны, но они не место для персональных данных, коммерческой тайны, исходного кода и внутренней переписки. Внедрение искусственного интеллекта в компанию должно включать не только выбор моделей и сценариев, но и политику работы с данными, DLP, обучение сотрудников и контроль.
Читайте также: