

Запуск ИИ-сервиса не заканчивается на обучении. Готовую модель переводят в продуктивный GPU-контур, где она начинает обрабатывать реальные пользовательские запросы. На старте существующих мощностей часто хватает, хотя требования сильно зависят от самой модели и сценария ее использования. По мере роста аудитории появляются пики нагрузки в разное время суток, аналитики запускают пакетные задания, а продуктовая команда параллельно тестирует новые версии модели. В одни часы ускорители работают на пределе, в другие часть мощностей простаивает, поэтому закупать оборудование с запасом под максимальный пик дорого и не всегда рационально.
Разберем, как добавить мощности без покупки нового оборудования, какую нагрузку оставить на своем сервере и в каких случаях использовать облачный GPU, bare metal или суперкомпьютер.
Пик нельзя усреднить
Нагрузка на GPU складывается из разных задач, и далеко не все из них идут по расписанию. Обучение новой версии модели часто удается запланировать заранее, но те же мощности могут понадобиться для тестов, пакетной обработки или отдельных запусков инференса. После выхода модели в продукт к этому добавляется пользовательская нагрузка. Инференс, то есть обработка моделью реальных запросов, уже зависит от поведения аудитории и внутренних процессов компании, которые редко совпадают с планами инфраструктурной команды.
У разных сервисов свой ритм. ИИ-помощник получает больше запросов утром, рекомендательная система активнее работает вечером, а распознавание документов сильнее загружено в конце отчетного периода. В те же часы команда может запускать переиндексацию базы знаний, A/B-тест новой версии модели или пакетную обработку накопившихся данных. В результате несколько задач одновременно претендуют на одни и те же GPU, а нагрузка растет гораздо быстрее привычного фонового уровня.
Средняя загрузка здесь дает мало информации о том, что происходит в самые напряженные часы. Она сглаживает короткие всплески, поэтому сервер, подобранный по среднему значению, во время пика начнет собирать очередь. Конфигурация с большим запасом решает эту проблему ценой простоя: большую часть месяца часть ускорителей будет ждать следующего всплеска.
Поэтому постоянную загрузку удобнее отделить от временной. Собственный сервер продолжает обслуживать предсказуемый поток задач, а дополнительные GPU подключаются на период пика, пакетного прогона или тестирования новой версии модели. Тогда редкий всплеск нагрузки не становится причиной покупать оборудование, которое понадобится на несколько часов или дней.
Очередь не всегда требует новой карты
Когда пользователи начинают жаловаться на задержки, подозрение часто сразу падает на GPU. Иногда проблема действительно в нехватке вычислительной мощности или видеопамяти, но очередь нередко возникает раньше, на других этапах обработки запроса. Данные могут медленно читаться из хранилища, батчинг — работать неэффективно, CPU — быть перегружен, а подготовка входного контекста — занимать слишком много времени. В таком случае новая видеокарта не устранит узкое место, а просто добавит мощности к той части системы, которая и так справляется.
Перед расширением инфраструктуры стоит собрать профиль реальной нагрузки. Для моделей с фиксированным результатом, например классификаторов, детекторов или моделей распознавания, его формируют из нескольких показателей:
- RPS показывает число обработанных запросов в секунду;
- p95 и p99 помогают увидеть задержки для самых медленных запросов;
- длина очереди показывает, успевает ли сервис справляться с входящим потоком;
- загрузка GPU и видеопамяти помогает понять, насколько полно используются ускорители.
Для LLM профиль шире, поскольку ответ генерируется последовательно и может сильно различаться по длине, поэтому дополнительно смотрят на число одновременно обрабатываемых последовательностей, скорость генерации токенов и заполнение KV-кеша. Отдельно измеряют TTFT, то есть время до появления первого токена, и ITL — задержку между последующими токенами.
Если TTFT растет, а дальше модель генерирует с привычной скоростью, запросы, скорее всего, ждут своей очереди или долго проходят подготовку промпта. Рост ITL уже указывает на проблемы непосредственно во время генерации.
Собрать эти показатели и провести нагрузочное тестирование можно, например, с помощью NVIDIA GenAI-Perf. В тесте стоит воспроизводить реальные длины промптов и ответов, число параллельных пользователей и характер нагрузки из production.
Сотня одинаковых запросов даст аккуратный график, но плохо покажет поведение сервиса в рабочий день. Для бизнеса показательнее goodput — число запросов, которые система успела обработать в пределах заданного времени ответа. Именно этот показатель показывает, сколько полезной нагрузки инфраструктура действительно выдерживает под требования продукта.
Где брать дополнительные мощности
Облачная виртуальная машина с GPU, выделенный сервер и HPC-кластер решают разные задачи. Выбор зависит от продолжительности нагрузки, требований к изоляции и размера модели.
Вариант 1 — облачный GPU для коротких пиков
Благодаря vGPU физический ускоритель можно разделить на изолированные виртуальные ресурсы с заданным объемом видеопамяти и вычислительных ресурсов. Например, RTX PRO 6000 Blackwell Server Edition поддерживает профили в режиме MIG-backed vGPU на 12, 24, 48 и 96 ГБ.
Такой вариант удобен для A/B-теста, ночного batch-прогона или сервиса с выраженными сезонными скачками. Ресурс можно подключить на несколько часов, а после завершения задачи выключить.
Между командой на масштабирование и первым обработанным запросом неизбежно проходит время. Сначала запускается виртуальная машина, затем загружаются контейнер и веса модели, прогреваются CUDA-контекст и кэши. Для интерактивного сервиса такая пауза может оказаться критичной, поэтому хотя бы одну резервную реплику стоит держать готовой к работе или включать заранее при первых признаках роста нагрузки.
Пакетные задания допускают ожидание в несколько минут, и для них пул можно полностью выключать после завершения обработки.
Вариант 2 — bare metal для ровной загрузки
Если ускоритель занят большую часть суток, гибкая оплата по часам постепенно теряет смысл. Здесь проще использовать bare metal — выделенный сервер, все ресурсы которого принадлежат одному заказчику.
На такой машине доступна полная видеопамять GPU, несколько ускорителей можно связать между собой, а программный стек настроить под конкретную модель. Выделенный сервер также удобен при строгих требованиях к изоляции и предсказуемой производительности.
Bare metal часто становится основным контуром для постоянной высокой нагрузки, а облачные виртуальные машины принимают временный избыток запросов. Покупать сервер для этого необязательно — аренда сохраняет расходы в OPEX и избавляет компанию от ожидания поставки оборудования.
Вариант 3 — суперкомпьютер для распределенных задач
Суперкомпьютер нужен только там, где вычислительная задача уже не помещается в рамки одного сервера. Обычно речь идет об обучении крупных моделей, масштабных научных расчетах, больших пакетных прогонах или других сценариях, где вычисления приходится распределять сразу между несколькими узлами.
Если говорить об инференсе среднего масштаба, необходимость суперкомпьютера зависит от нескольких факторов: размера модели, ожидаемой нагрузки, целевых показателей по скорости ответа и доступности сервиса, а также требований к отказоустойчивости. Во многих случаях распределенный кластер здесь не нужен.
Если после нагрузочного тестирования видно, что модель и рабочая нагрузка укладываются в один сервер с несколькими GPU и при этом система выдерживает нужный объем запросов, дополнительная кластеризация только усложнит архитектуру.
В такой ситуации кластер может добавить лишнюю межузловую сеть, дополнительные механизмы хранения и оркестрации, а вместе с ними — более сложную эксплуатацию без заметного выигрыша для бизнеса.
Как подключить облако и не перевозить туда весь проект
Для этого необязательно переносить в облако всю инфраструктуру — основной контур, данные и постоянную GPU-нагрузку можно оставить локально, а облако использовать как дополнительный вычислительный пул, который подключается только в моменты пиков. Локальный GPU-сервер продолжает обрабатывать основной поток, а при росте очереди или задержки маршрутизатор направляет часть запросов на дополнительные реплики в облаке. В результате в облако выносится только тот фрагмент системы, которому в конкретный момент нужны дополнительные вычислительные ресурсы.
Чтобы такое переключение оставалось незаметным для пользователя, локальные и облачные реплики должны давать одинаковый результат при одинаковом запросе. Для этого нужно синхронизировать контейнеры, веса модели, токенизатор, версии библиотек и параметры генерации. Если конфигурации разойдутся, качество и содержание ответа могут зависеть от того, в каком контуре оказался запрос.
При этом облачные реплики нужно подготовить так, чтобы они могли быстро включиться в работу. Если модель занимает сотни гигабайт, скачивать ее заново при каждом всплеске нагрузки бессмысленно, ведь значительная часть пика пройдет еще до запуска дополнительного экземпляра. Необходимые модели, контейнерные образы и зависимости лучше заранее сделать доступными в облачном контуре или кэшировать там, где будут запускаться реплики. Это не означает перенос всего проекта в облако: речь идет только о компонентах, необходимых для запуска инференса.
Дальше масштабирование можно автоматизировать. Например, Kubernetes HPA увеличивает число реплик по пользовательским метрикам, а KEDA удобно использовать для очередей и пакетных заданий. Она запускает обработчики при появлении работы, а после завершения нагрузки снова уменьшает их число.
Интерактивный LLM-сервис требует более осторожной автоматики, поскольку одной длины очереди для принятия решения недостаточно. К ней добавляют TTFT, число активных последовательностей, заполнение KV-кэша, доступную память и количество уже прогретых реплик. Так облачный пул подключается до того, как пользователь заметит рост задержки.
Перед расширением пула стоит проверить батчинг. NVIDIA Triton объединяет входящие запросы в пакеты. Для LLM используется continuous batching, который реализован, например, в vLLM. Когда одна последовательность завершает генерацию, ее место сразу занимает следующая.
За рост пропускной способности приходится платить ожиданием. Если система слишком долго собирает подходящий батч, экономия на GPU превращается в задержку на стороне пользователя. Размер пакета и время ожидания подбирают нагрузочным тестом, а не по универсальной рекомендации из документации.
A/B-тесты лучше выносить в отдельный пул. Постоянное переключение весов на одной карте тратит время и сбрасывает кэши. Новой версии сначала отдают теневой трафик или небольшую долю реальных запросов, после чего сравнивают качество, TTFT, ITL и стоимость обработки.
На случай резкого всплеска понадобятся лимит очереди, тайм-аут и запасной сценарий. Сервис может сократить максимальную длину ответа, временно отправить часть запросов на компактную модель или отказаться от второстепенной обработки. Такая деградация обычно лучше бесконечного ожидания.
Какая карта нужна для инференса
Определите, сколько памяти требуется модели. В нее должны поместиться веса, рабочие буферы и KV-кэш при запланированном числе одновременных запросов. На итог влияют точность вычислений, длина контекста и параметры батчинга.
Следом проверьте производительность на собственной модели и с целевым SLO. Паспортные TOPS позволяют сравнить ускорители в теории, но не показывают скорость конкретного сервиса с его промптами, контекстом и настройками.
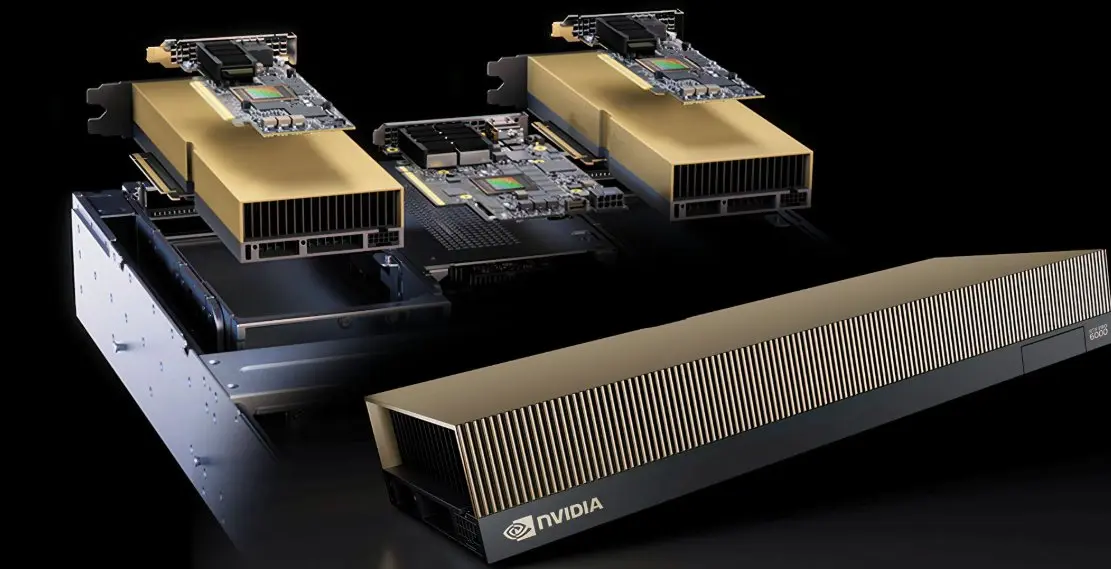
NVIDIA RTX PRO 6000 Blackwell Server Edition получила 96 ГБ памяти GDDR7 с ECC и поддерживает разделение на изолированные экземпляры. Она подходит моделям среднего размера, нескольким параллельным сервисам и тестированию разных версий. Если весь объем памяти не нужен, часть карты можно выделить через vGPU.
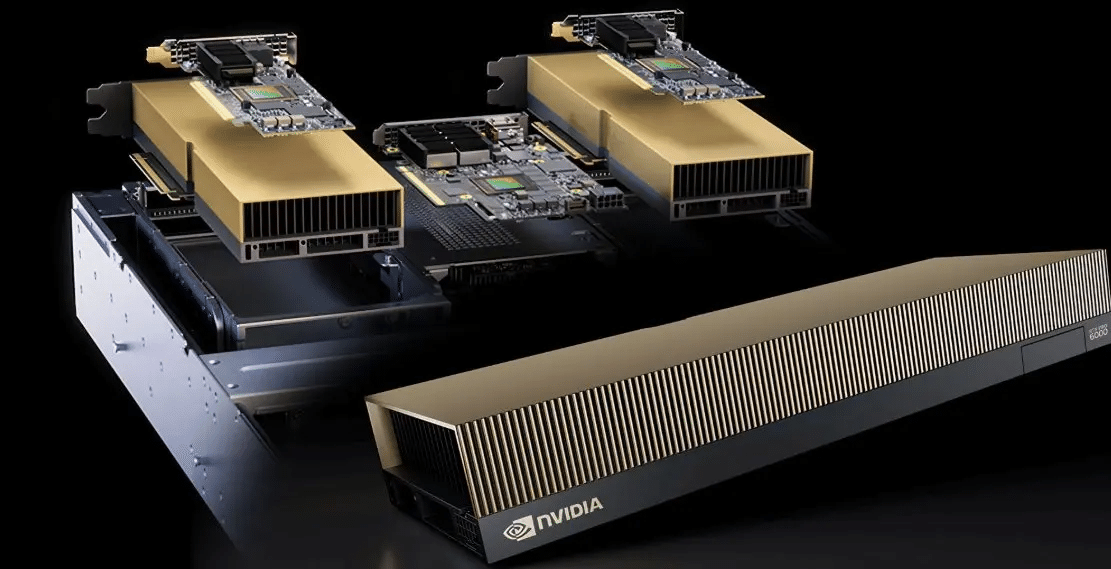
NVIDIA H200 оснащена 141 ГБ HBM3e с пропускной способностью 4,8 ТБ/с. Дополнительная память пригодится для тяжелых LLM, длинного контекста и крупного KV-кэша. Но не стремитесь сразу покупать несколько H200, ведь распределение модели между картами добавляет обмен данными.
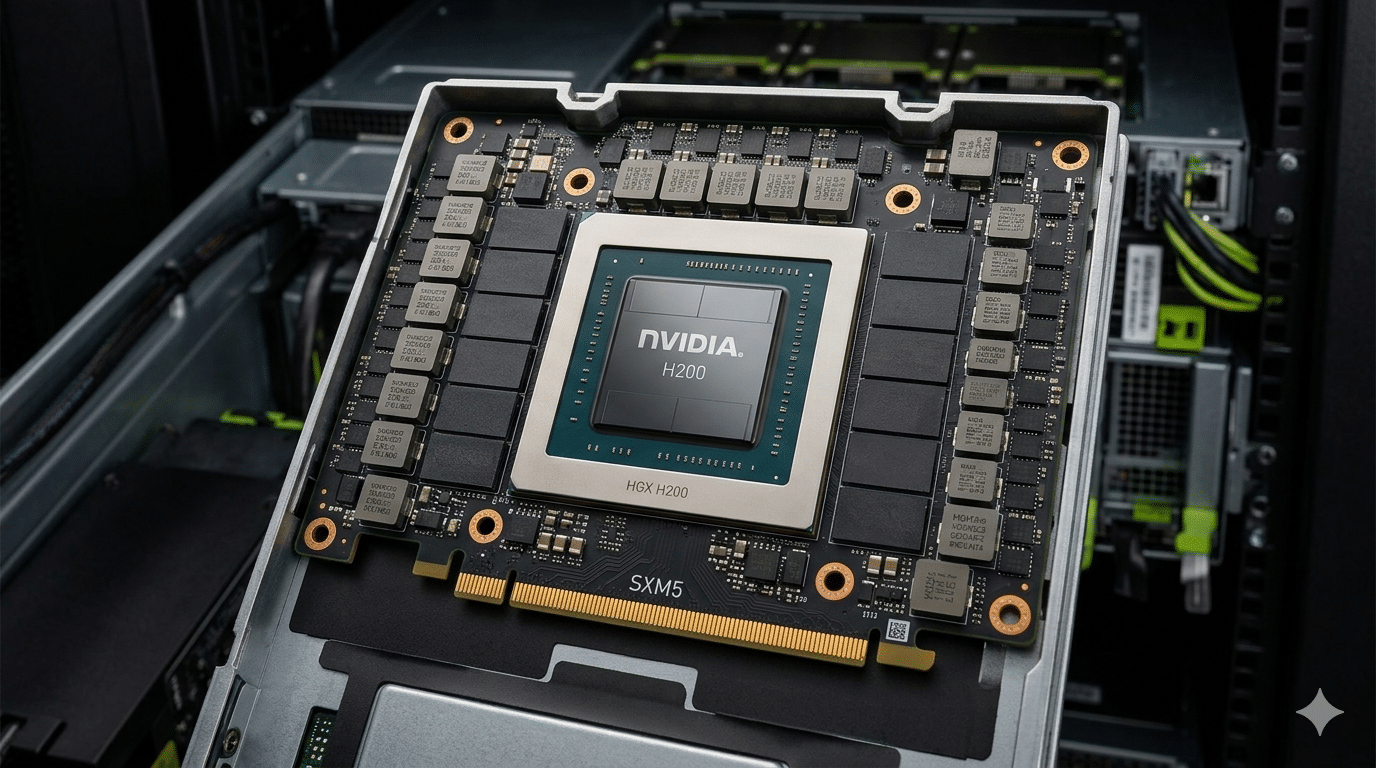
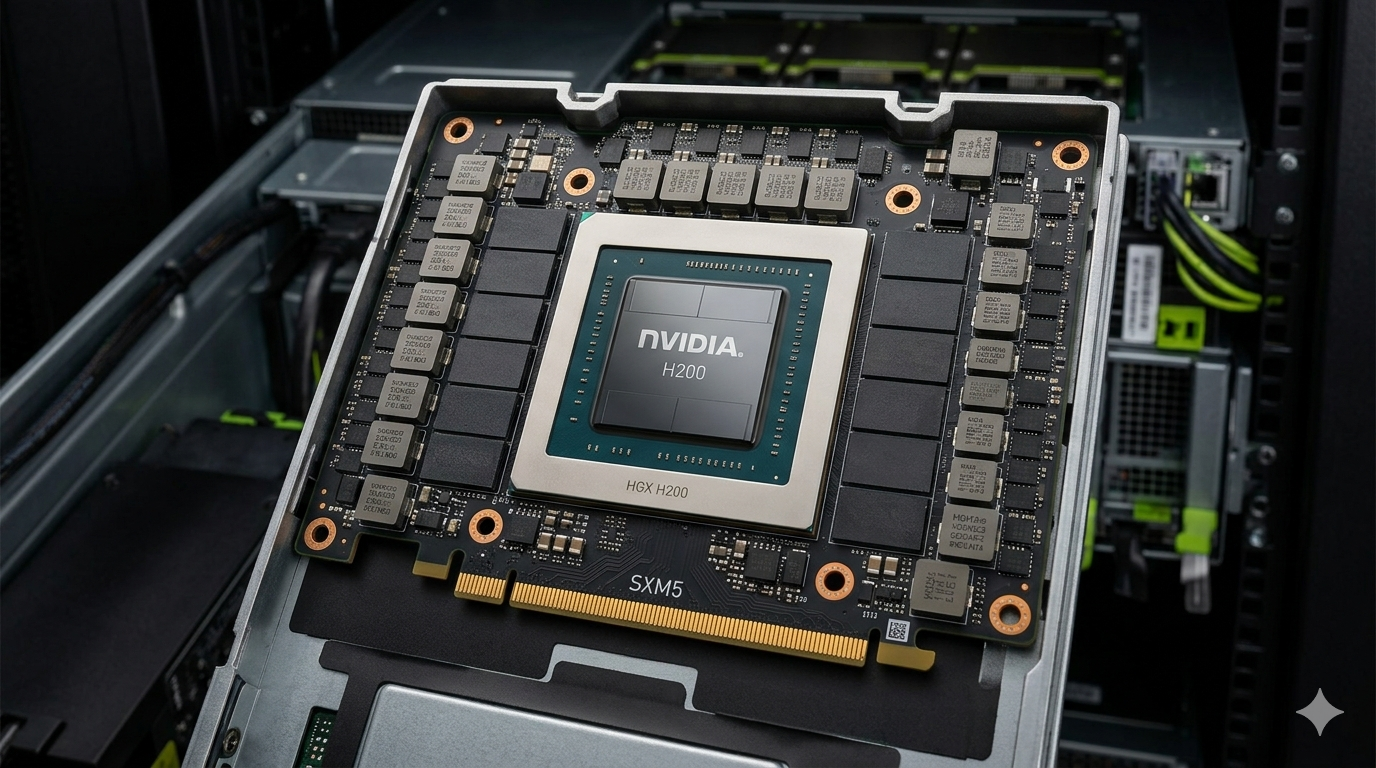
Когда профиль нагрузки уже собран, внешний пул можно подобрать под конкретный сценарий. Например, в GPU Cloud ITGLOBAL.COM RTX PRO 6000 Blackwell доступна в конфигурациях на 12, 24, 48 и 96 ГБ, а H200 предоставляется с полными 141 ГБ памяти. Для более ресурсоемких задач можно использовать конфигурации с двумя или четырьмя GPU. Если виртуальной инфраструктуры недостаточно или проект требует изоляции и предсказуемой производительности, те же вычислительные задачи можно перенести на выделенные GPU-серверы.
Для первого теста модели среднего размера подойдет vGPU, а тяжелую LLM с длинным контекстом можно проверить на H200 без покупки собственного сервера.
Сколько на самом деле стоит свой GPU
При сравнении собственной инфраструктуры и облака важно смотреть не только на цену самого GPU. Покупка сервера означает крупные первоначальные вложения в оборудование, после которых компания берет на себя расходы на его размещение, обслуживание и дальнейшую эксплуатацию. При этом оборудование оплачивается сразу, даже если фактическая нагрузка на него окажется ниже ожидаемой.
В облаке компания получает нужную GPU-конфигурацию без капитальных затрат и платит за ресурсы по мере использования. Это удобно на этапе пилота, при неравномерной нагрузке или в ситуациях, когда заранее сложно понять, сколько вычислительной мощности понадобится через несколько месяцев. При росте нагрузки емкость можно увеличить, а после завершения пика снова сократить, не оставляя простаивающее оборудование на балансе.
Если GPU нужен постоянно, почасовая аренда тоже не всегда оптимальна. В таких случаях ресурсы можно закрепить за проектом на более длительный срок. У некоторых провайдеров для этого используется Allocated Pool — заранее зарезервированный пул GPU с фиксированной ежемесячной оплатой. Такой вариант сохраняет преимущества облачной инфраструктуры, но делает расходы более предсказуемыми.
В итоге сравнивать собственный сервер и облако лучше не по стоимости одной видеокарты, а по тому, сколько в итоге обходится работа приложения. Для одного проекта это стоимость обработанного запроса, для другого — миллиона сгенерированных токенов или выполненного пакетного задания. При непостоянной загрузке облачная модель часто выигрывает за счет того, что компания не оплачивает заранее мощности, которые большую часть времени будут простаивать.
Отдельно стоит учитывать расположение данных. Если приложение работает с корпоративными документами или большими массивами информации, архитектуру лучше изначально выстроить так, чтобы не передавать одни и те же данные между локальной площадкой и облаком при каждом запросе. Часть индексов, кэшей или других необходимых для инференса данных можно разместить ближе к облачному вычислительному пулу, оставив основное хранилище внутри корпоративного контура.
Как выбрать контур для инференса
Покупать новую карту после первого же роста очереди необязательно. Сначала проверьте батчинг, память, доступ к данным и поведение сервиса на реальном профиле запросов. После этого нагрузку можно разложить по подходящим контурам:
- свой сервер остается основой для предсказуемого потока;
- постоянный high-load можно перенести на арендованный bare metal, а облачному GPU передать пики, тесты и пакетные задания;
- суперкомпьютер понадобится только тогда, когда модель или вычислительная задача действительно вышла за пределы одного узла.
Такая схема позволяет наращивать мощности в темпе продукта и не ждать, пока очередная партия ускорителей пройдет закупку, поставку и ввод в эксплуатацию.
Читать также: