

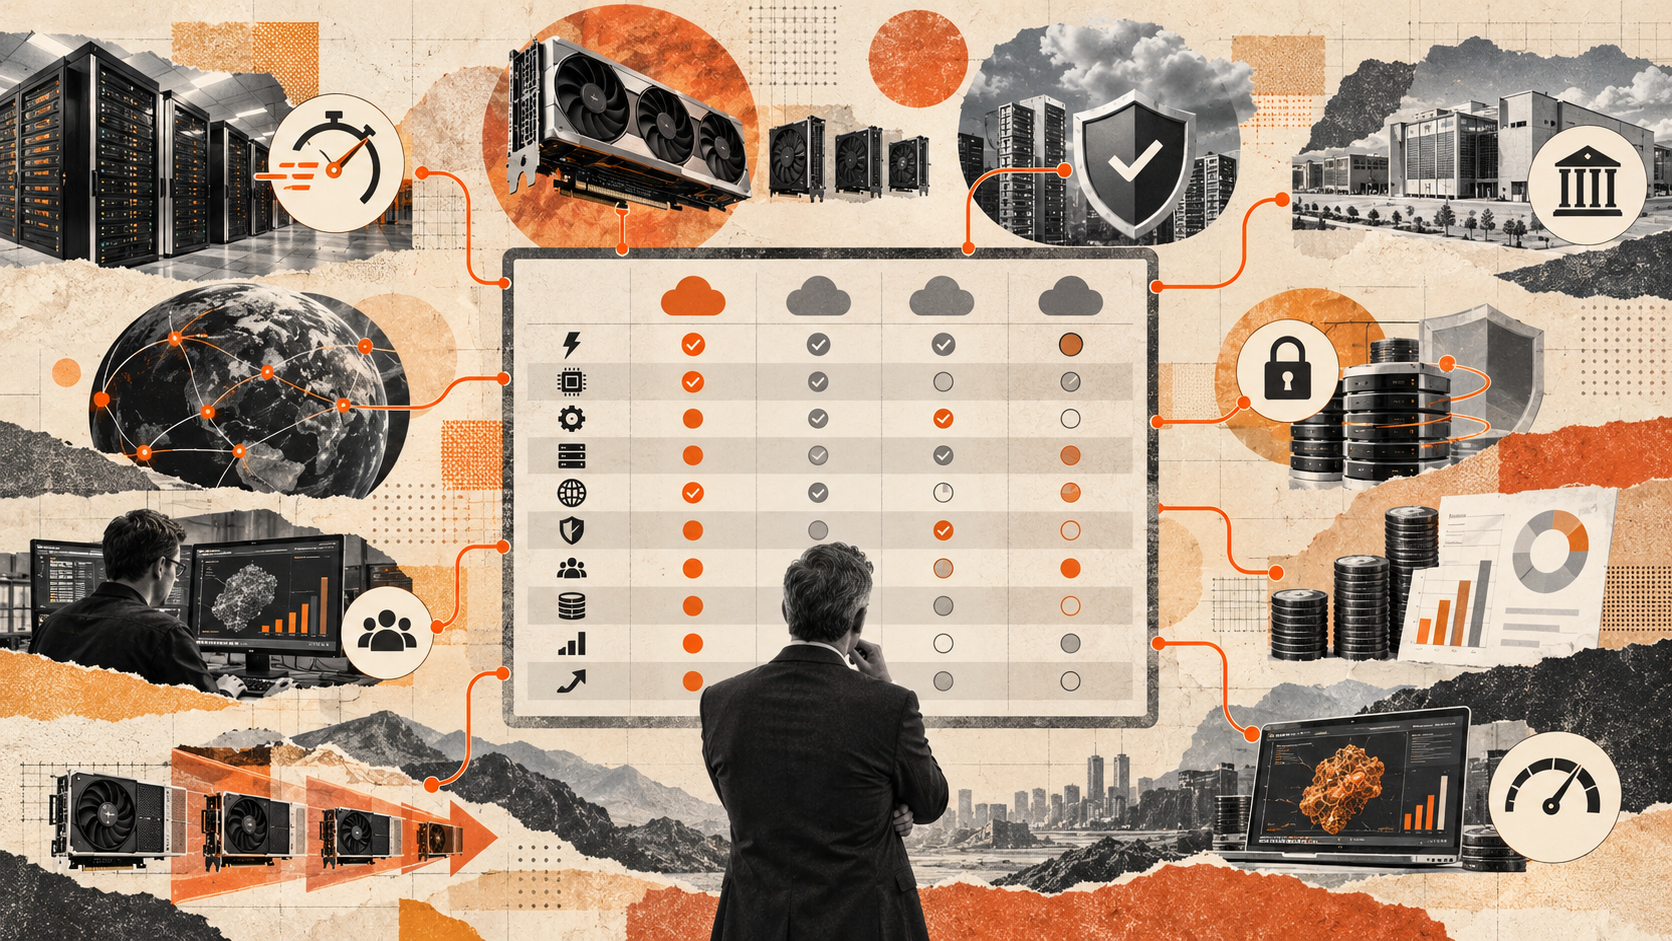
Выбор GPU-провайдера редко сводится к модели ускорителя и цене аренды. Важнее, сможет ли поставщик выдать нужную конфигурацию в требуемый срок, обеспечить предсказуемую производительность, быстрый доступ к данным, необходимый уровень изоляции и возможность масштабироваться без остановки проекта. На основе этого сравнивать стоит весь сервис целиком — от вычислений и хранилища до SLA, поддержки и обновления парка. Мы собрали матрицу из десяти критериев, которая поможет CTO быстро отсеять неподходящие варианты еще до тест-драйва и договора.
Критерий 1. Физическая доступность парка
Важно не то, какая карта указана в каталоге, а какую конфигурацию можно получить сейчас. Если нужна аренда сервера с GPU, уточняйте количество свободных ускорителей, срок запуска, необходимость резервирования и возможность быстро нарастить ресурсы. Список GPU сам по себе ничего не говорит о том, будет ли оборудование доступно сегодня или только после поставки.
Провайдер должен четко говорить о том, сколько этого оборудования уже развернуто и готово к работе. Некоторые игроки, например, заранее резервируют ресурсы и держат оборудование в наличии, обеспечивая быстрый запуск проектов.
Критерий 2. Несколько классов карт под разные нагрузки
Универсальной GPU-карты не существует. GPU сервер для машинного обучения, сервер для рендеринга и GPU сервер для ИИ требуют разных характеристик. Хороший провайдер предлагает несколько линеек ускорителей под разные сценарии.
В российском облаке стоит искать как минимум:
- NVIDIA A100 / A800 — для широкого спектра задач ИИ и HPC;
- NVIDIA H100 / H200 — для обучения больших языковых моделей и самых требовательных вычислений;
- NVIDIA RTX PRO 6000 Blackwell Server Edition — для инференса, промышленного ИИ и профессиональной графики.
Одновременно важно понимать формат. Виртуальный сервер с видеокартой, VPS-сервер с GPU или VDS с GPU у разных поставщиков могут означать разные способы выделения ресурсов. За этими названиями может стоять полный проброс физического GPU в одну виртуальную машину, time-sliced vGPU или аппаратное разделение через MIG. Эти варианты отличаются уровнем изоляции, предсказуемостью производительности и плотностью размещения ВМ.
При выборе карты важно уточнять не только объем доступной видеопамяти, но и способ виртуализации, гарантированные ресурсы и наличие аппаратной изоляции.
Критерий 3. SLA и отказоустойчивость
SLA (Service Level Agreement, или соглашение об уровне обслуживания) — это те цифры в договоре, которые служат защитой от простоев. SLA должен фиксировать доступность, реакцию на инциденты и порядок компенсаций. Обращайте внимание на гарантированную доступность, время реакции на инциденты и порядок компенсаций.
Значение SLA нужно сравнивать между поставщиками вместе с архитектурой отказоустойчивости, поскольку одинаковый процент доступности сам по себе еще не показывает, как сервис поведет себя при отказе отдельного узла.
Когда аренда GPU-мощностей используется для распределенного обучения, проверяйте также сеть между узлами. Аренда вычислительных мощностей для обучения нейросети — это не только GPU, но и CPU, RAM, система хранения данных и пропускная способность соединений.
Критерий 4. Сертификация ЦОД
Уровень Tier III по классификации Uptime Institute означает Concurrently Maintainable — отдельные компоненты и пути распределения инфраструктуры можно планово выводить на обслуживание без остановки ИТ-нагрузки. При этом Tier III не означает полной отказоустойчивости при любых авариях — это уже отдельное требование уровня Tier IV.
Для многих бизнес-критичных нагрузок Tier III становится разумным ориентиром, хотя требуемый уровень надежности зависит от самого сервиса и архитектуры резервирования.
Проверяйте не только упоминание Tier III на сайте, но и конкретный тип сертификата Uptime Institute и объект, к которому он относится. Сертификация проектной документации и сертификация уже построенного ЦОД — разные вещи.
Критерий 5. География площадок
Для российского бизнеса география влияет и на задержку, и на комплаенс. При сборе персональных данных граждан РФ часть 5 статьи 18 152-ФЗ по общему правилу не допускает использование зарубежных баз для их записи, систематизации, накопления, хранения, уточнения и извлечения. Уточняйте не только расположение GPU, но и где находятся хранилища, журналы, резервные копии и другие компоненты обработки данных.
Но и международное присутствие — это плюс. Например, если ваш бизнес работает в нескольких странах или вы планируете выход на зарубежные рынки, возможность развернуть инфраструктуру рядом с пользователями дает серьезное преимущество.
Критерий 6. Соответствие 152-ФЗ и защищенный контур
Если аренда GPU для ИИ используется с чувствительными данными, выясняйте распределение ответственности, сетевую сегментацию, журналирование, управление доступом и возможность изолированного контура. Закон возлагает на оператора обязанности по организации обработки и защите персональных данных.
Для чувствительных проектов стоит отдельно оценивать уровень изоляции. В одних случаях потребуется выделенный bare-metal сервер, в других достаточно виртуализированной среды с аппаратным разделением GPU, сетевой сегментацией и строгим разграничением доступа.
Критерий 7. Managed-услуги и экспертиза
Получить GPU сервер — только начало. Нужны драйверы, CUDA, совместимые фреймворки, мониторинг, сеть, хранилище и обновления. Поэтому, например, аренда GPU для машинного обучения должна оцениваться вместе с качеством поддержки.
Уточняйте границы managed-сервиса (управляемых сервисов). Провайдер может взять на себя мониторинг инфраструктуры, обновления драйверов, обслуживание виртуализации и часть задач безопасности, но конкретный набор зависит от SLA и договора.
Для VDI и инженерной графики отдельно проверяйте наличие аренды удаленных рабочих станций с GPU, для AI-production — аренду GPU сервера для ИИ.
Практичный ориентир — посмотреть, что провайдер включает в сервис помимо самого ускорителя. Например, ITGLOBAL.COM публикует типовые конфигурации H200, RTX PRO 6000 Blackwell Server Edition и A100/A800 с объемом vCPU и RAM, а также параметры сети, SLA и условия тестирования сервиса. Такие подробности помогают правильно сравнить сервисы по фактической конфигурации, а не по одной модели GPU.
Критерий 8. Прозрачная тарификация
Сравнивать только стоимость карты неправильно. Важно понимать, из чего складывается цена. Аренда видеокарты и аренда сервера с видеокартой включают разный объем ресурсов: GPU, vCPU, RAM, диски, трафик, лицензии и поддержку. Уточняйте единицу тарификации, минимальный срок, правила округления и стоимость масштабирования.
Для переменной нагрузки может быть удобна почасовая или поминутная тарификация, а для постоянного продакшена — заранее зарезервированный пул с фиксированной стоимостью. Важно заранее сопоставить модель оплаты с профилем собственной нагрузки.
Прозрачная тарификация позволяет точно прогнозировать бюджет и сравнивать предложения разных провайдеров по сопоставимым метрикам. Обращайте внимание на наличие фиксированных тарифов и понятной формулы расчета.
Критерий 9. Тест-драйв
GPU-инфраструктуру невозможно оценить по документации. Реальная производительность зависит от множества факторов: версии драйверов, конфигурации виртуализации, сетевой задержки между узлами, особенностей вашего кода.
Обязательно до договора запускайте собственный код и датасет. Проверяйте скорость обучения или инференса, загрузку GPU, сеть и стабильность драйверов. Это особенно важно, если рассматриваются аренда виртуальных машин с GPU или аренда VPS с GPU. Производительность зависит не только от модели ускорителя, но и от способа виртуализации и соседних ресурсов.
Если тестового доступа нет, стоит запросить результаты нагрузочных испытаний на сопоставимой конфигурации и максимально подробно зафиксировать параметры производительности в договоре.
Критерий 10. Дорожная карта обновления парка
GPU-парк обновляется заметно быстрее многих других компонентов серверной инфраструктуры. NVIDIA и другие производители регулярно выпускают новые архитектуры и отдельные ускорители, а смена поколения может существенно изменить производительность, объем памяти, энергопотребление и экономику AI-нагрузки. Если провайдер не обновляет парк оборудования, вы рискуете застрять на устаревших решениях, когда конкуренты уже используют более мощные и эффективные ускорители.
Смена поколения может повлиять на архитектуру обучения и инференса. Спрашивайте у провайдера, какие карты планируются к вводу в ближайшие 12–18 месяцев, а также узнайте, насколько оперативно компания реагирует на появление новых моделей. Это покажет, насколько серьезно провайдер инвестирует в развитие GPU-направления.
Как применить матрицу на практике
Возьмите эти 10 критериев и оцените каждого кандидата по трехбалльной шкале: «подтверждено», «есть ограничения», «не подтверждено». Отдельно отметьте стоп-факторы: отсутствие нужного GPU, требуемой географии, тестового доступа или приемлемого SLA.
| Критерий | Что проверить | Почему критерий важен |
| 1. Доступность и выбор GPU | Какие карты реально есть в наличии, сколько их можно получить и как быстро | Каталог ничего не гарантирует, если нужную конфигурацию придется ждать несколько недель |
| 2. Формат предоставления ресурсов | Выделяется ли полный GPU, виртуальная часть ускорителя или отдельный физический сервер | От этого зависят изоляция, предсказуемость производительности и возможность масштабирования |
| 3. Хранилище и доступ к данным | Используются ли локальные NVMe или сетевые диски, какая скорость доступа к датасету | Быстрый GPU не даст ожидаемого эффекта, если вычисления постоянно ждут загрузки данных |
| 4. SLA и отказоустойчивость | Гарантированная доступность, резервирование, время реакции и компенсации | Для прода важна работа всей инфраструктуры, а не только самого ускорителя |
| 5. ЦОД и география | Где физически находятся вычисления, данные и резервные копии, какой уровень надежности площадки | Это влияет на задержку, требования бизнеса к размещению данных и устойчивость сервиса |
| 6. Безопасность и изоляция | Разграничение доступа, сегментация, журналы, выделенный контур, требования 152-ФЗ | Чем чувствительнее данные, тем важнее понимать границы ответственности провайдера и заказчика |
| 7. Поддержка и экспертиза | Что входит в managed-сервис и насколько глубоко провайдер помогает с эксплуатацией | Получить GPU недостаточно, инфраструктуру еще нужно сопровождать и развивать |
| 8. Тарификация | Что входит в стоимость, как считается время, сколько стоят диски, трафик и масштабирование | Низкая цена GPU сама по себе еще не означает низкую итоговую стоимость проекта |
| 9. Тест-драйв | Можно ли проверить собственную нагрузку, данные и сценарии до долгосрочного договора | Реальная производительность часто отличается от характеристик на бумаге |
| 10. Обновление GPU-парка | Какие поколения доступны сейчас и как часто появляются новые | Для долгих проектов важно не быть привязанным к устаревшей инфраструктуре |
Также разделяйте типы сервиса. Для эксперимента подходят облачные вычисления GPU. Для задач, где нужен эксклюзивный доступ к физическим ускорителям и предсказуемая производительность, подойдет выделенный GPU-сервер. Для ML-задач встречаются форматы аренды видеокарт для нейросетей.
В ТЗ лучше фиксировать модель и число GPU, видеопамять, CPU/RAM, диски, сеть, изоляцию, географию, соглашение об уровне обслуживания (SLA) и масштабирование. Тогда различные маркетинговые формулировки поставщиков становятся не разными продуктами, а вариантами поиска инфраструктуры под одну задачу.
Часто задаваемые вопросы
Как выбрать облачного GPU-провайдера?
Начинать стоит с требований конкретного проекта. Сравните доступные модели и количество GPU, формат предоставления ресурсов, SLA, расположение ЦОД, возможности масштабирования, требования к безопасности и итоговую стоимость инфраструктуры. Отдельно стоит проверить оборудование на собственной нагрузке до заключения долгосрочного договора.
Что лучше выбрать: виртуальный или выделенный сервер с GPU?
Виртуальный сервер с GPU часто удобен для пилотов и инференса, поскольку его проще конфигурировать и масштабировать в пределах доступного пула провайдера. При этом возможность быстро добавить GPU зависит от фактического наличия ускорителей.
Выделенный сервер имеет смысл, когда проекту требуется предсказуемая производительность, постоянная высокая нагрузка или дополнительная изоляция. Выбор зависит от задачи, поэтому важно уточнять не название услуги, а способ предоставления GPU и гарантированный объем ресурсов.
Какие GPU подходят для обучения и инференса нейросетей?
Для разных задач требования отличаются. NVIDIA A100 и отдельные конфигурации A800 — для AI, ML и HPC-нагрузок предыдущего поколения, H100 и H200 ориентированы на более ресурсоемкое обучение и инференс крупных моделей. RTX PRO 6000 Blackwell Server Edition может использоваться для инференса, профессиональной графики и других GPU-нагрузок. При выборе стоит учитывать не только поколение ускорителя, но и объем видеопамяти, необходимую производительность и стоимость часа или месяца работы.
Что нужно проверить во время тест-драйва GPU-сервера?
Лучше запускать тот же код и данные, которые будут использоваться после перехода в production. Стоит измерить скорость обучения или инференса, загрузку и доступную память GPU, производительность хранилища и сети, стабильность драйверов и поведение системы под длительной нагрузкой. Такой тест дает гораздо больше информации, чем сравнение характеристик ускорителей на бумаге.
Почему при выборе GPU-провайдера нельзя сравнивать только цены?
Цена самого GPU показывает лишь часть расходов. В итоговый счет могут входить vCPU, RAM, диски, сетевой трафик, лицензии, резервирование и дополнительные услуги. Кроме того, более дешевое предложение может проиграть по производительности, поэтому корректнее сравнивать стоимость выполнения конкретной задачи, например обучения модели или обработки определенного числа запросов.
Важно ли SLA при аренде GPU в облаке?
Да, особенно если GPU используются в production. Соглашение об уровне обслуживания определяет гарантированную доступность сервиса, условия реакции на инциденты и компенсации при нарушении обязательств. Для распределенных вычислений также стоит отдельно проверять надежность сети, хранилищ и других компонентов, от которых зависит работа GPU-кластера.
Как проверить, подходит ли облачный GPU для работы с персональными данными?
Нужно выяснить, где физически выполняются вычисления и хранятся данные, журналы и резервные копии, какие механизмы разграничения доступа и изоляции предлагает провайдер и как распределяется ответственность между ним и заказчиком. Само размещение GPU в российском ЦОД не гарантирует соответствия требованиям 152-ФЗ — организация остается ответственной за выполнение применимых требований к обработке и защите персональных данных.
В итоге выбор облачного GPU-провайдера лучше начинать с требований проекта. Важно заранее понимать, какая производительность нужна, где должны находиться данные, насколько быстро придется масштабироваться, какие требования есть к SLA и безопасности и кто будет сопровождать инфраструктуру. Если сравнивать провайдеров по этим критериям и обязательно проверять сервис на собственной нагрузке, риск переплатить за неподходящую конфигурацию или столкнуться с ограничениями уже в проде заметно снижается.