

Когда руководство ставит задачу «внедрить ИИ», сразу начинается дискуссия об инфраструктуре. Однако команда еще не знает, какую модель будет использовать, сколько сотрудников подключатся к сервису, какой объем запросов возникнет и принесет ли проект бизнесу измеримый эффект, но уже выбирает GPU-сервер. В результате компания покупает мощности под гипотезу, которая через несколько месяцев может измениться или вовсе не подтвердиться.
Для пилотного ИИ-проекта логичнее сначала проверить сценарий на арендованной инфраструктуре, измерить реальную нагрузку и только после этого решать, нужен ли собственный GPU-сервер. В статье расскажем, почему такой подход снижает первоначальные затраты, позволяет быстрее менять конфигурацию и дает бизнесу цифры, на основании которых уже можно сравнивать облако, выделенный сервер и покупку оборудования.
Почему покупка GPU-сервера до пилота фиксирует то, чего бизнес еще не знает
Допустим, компания хочет запустить внутреннего ИИ-ассистента. Идея проекта в том, что сотрудники будут задавать вопросы по корпоративным документам, а система станет находить ответы. Но из нее невозможно понять, какая инфраструктура понадобится через полгода.
Сначала сервисом могут пользоваться 50 человек, затем 500 или 5 000. Первоначальная модель может оказаться слишком дорогой, медленной или просто хуже конкурента. После тестирования может выясниться, что задачу решает модель меньшего размера или, наоборот, первоначально выбранной конфигурации недостаточно. Сам проект тоже может измениться — вместо ассистента для всей компании бизнес решит оставить ИИ только в поддержке или юридическом подразделении.
Microsoft в рекомендациях по внедрению ИИ отмечает, что перед внедрением важно разработать прототипы ИИ — это лучший способ проверить техническую реализуемость и бизнес-ценность до полномасштабного проекта. Результаты пилота помогают уточнить требования, сроки внедрения и необходимые ресурсы перед переходом к промышленному запуску. Для инфраструктуры логика такая же — сначала нужно измерить нагрузку, а затем под нее выбрать постоянную конфигурацию.
В итоге на старте вопрос должен быть о том, что именно мы хотим доказать этим пилотом. Покупка дорогой системы с датацентровыми GPU уровня NVIDIA H200 заранее отвечает на вопрос о мощности, хотя ответа на вопрос о самой нагрузке еще нет.
Когда инвестиции в GPU-инфраструктуру не оправданы
Риск 1. После пилота может понадобиться совсем другой GPU
В корпоративном ИИ нет универсальной конфигурации, которая одинаково хорошо подходит для любого проекта. Инфраструктура зависит от выбранной модели, количества пользователей, объема данных, требований к скорости работы и того, насколько равномерно распределена нагрузка.
Выбор модели тоже может измениться после пилота. Microsoft рекомендует подбирать технологию под конкретный сценарий, стоимость и требования проекта, поэтому модель, удобная для быстрого прототипа, не обязательно окажется оптимальной для прода. Из этого следует вывод о том, что до тестов невозможно уверенно определить, какая вычислительная мощность действительно понадобится.
Если еще до пилота приобрести GPU-сервер с запасом мощности под будущую промышленную нагрузку, возможны два одинаково неприятных сценария. В первом мощности не хватит, и инфраструктуру придется расширять почти сразу после покупки. Во втором значительная ее часть будет простаивать, а компания несколько лет будет амортизировать оборудование, которое использует лишь частично.
Облако позволяет начать с одной конфигурации и затем изменить объем ресурсов в пределах доступного GPU-пула провайдера. Например, можно начать с одной конфигурации, посмотреть на фактическое потребление и затем увеличить или уменьшить аренду GPU-мощностей. Кроме того, капитальная покупка при каждом таком эксперименте не требуется.
Риск 2. Оборудование изменится быстрее, чем корпоративные планы
GPU-сервер обычно покупают с расчетом на многолетнюю эксплуатацию, тогда как линейка ускорителей обновляется быстрее. Еще недавно смена ключевых архитектур NVIDIA происходила примерно раз в два года — Ampere появилась в 2020 г., Hopper в 2022 г., Blackwell в 2024 г. В январе 2026 года компания представила Vera Rubin, а партнерские системы на новой платформе должны появиться во второй половине года.
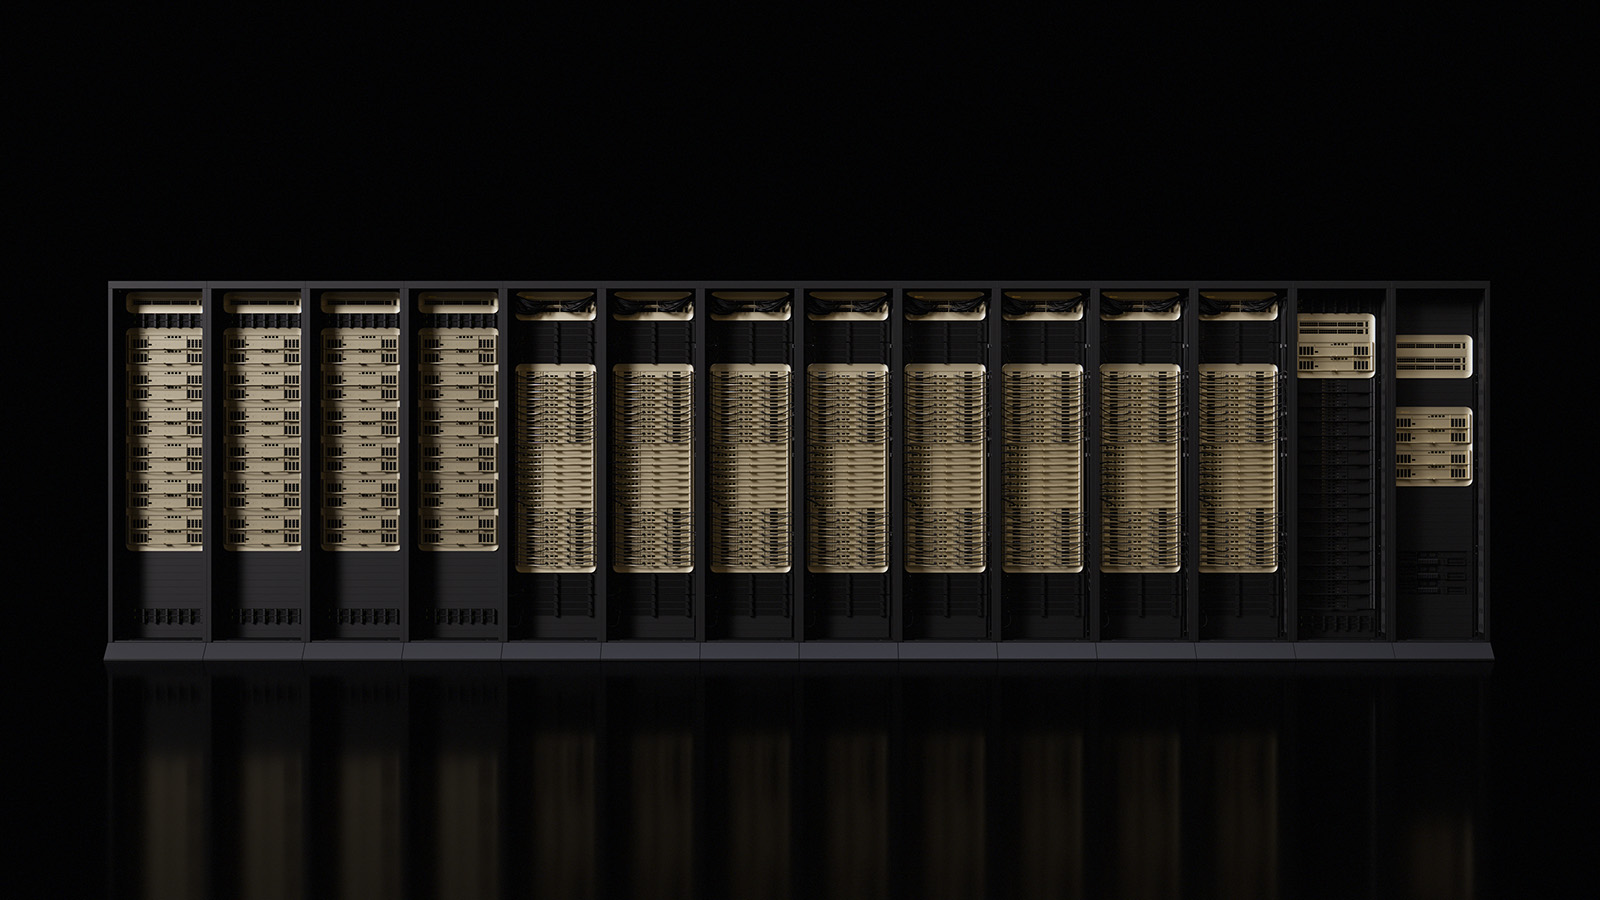
Это не значит, что H200 или другие ускорители предыдущих поколений станут бесполезными — они продолжат выполнять подходящие им задачи. Проблема возникает в момент покупки под проект, параметры которого еще неизвестны. Компания может несколько месяцев согласовывать бюджет, проводить закупку, ждать поставку и готовить инфраструктуру, а к моменту масштабирования выяснить, что рынок уже предлагает более подходящий вариант по производительности или стоимости эксплуатации.
При аренде GPU эта технологическая неопределенность становится менее болезненной, ведь для пилота важен доступ к вычислениям сегодня. При аренде конфигурацию можно пересмотреть после завершения пилота без необходимости списывать недавно приобретенное оборудование.
Риск 3. Неудачный пилот превратится в дорогой актив
Сам по себе провал пилотного ИИ-проекта вполне нормален, ведь пилот для того и проводится, чтобы дешево выяснить, работает ли гипотеза. Например, компания может планировать автоматизацию разбора входящих документов, но во время тестирования обнаружит, что качество исходных данных слишком низкое. В такой ситуации сразу будет понятно, что масштабироваться пока невыгодно.
Совсем иначе эта фраза воспринимается, если до начала проверки компания уже приобрела GPU-сервер. После крупной закупки может возникнуть дополнительное давление на команду — уже приобретенную инфраструктуру нужно загрузить, даже если первоначальная гипотеза оказалась слабее ожиданий. Так техническое решение начинает влиять на бизнес.
Облачная модель снимает значительную часть этого риска. Аренда сервера с GPU переводит первоначальные затраты из большой капитальной покупки в ограниченные расходы на период проверки. Если гипотеза не подтверждается, компания прекращает эксперимент. Если подтверждается, появляется основание для дальнейших инвестиций.
Что дает облако в первые недели пилота
Главное преимущество облака на этом этапе связано даже не с конкретной моделью оплаты — оно сокращает путь между идеей и измерением результата. Собственный сервер сначала нужно выбрать, согласовать, приобрести, доставить и ввести в эксплуатацию. В крупной организации каждый из этих этапов может превратиться в отдельный процесс. С облачным сервером с GPU вычислительная инфраструктура уже существует у провайдера, поэтому команда может гораздо раньше перейти к самому эксперименту.
Для пилота это особенно важно, ведь ценность первых недель заключается в полученных данных, а вовсе не в количестве закупленных GPU. К концу теста руководство должно получить ответы на пять вопросов:
- Решает ли ИИ исходную бизнес-задачу и насколько хорошо?
- Сколько пользователей или операций действительно будет у сервиса?
- Какая конфигурация обеспечивает приемлемую скорость и качество?
- Сколько стоит один полезный результат: обработанный документ, запрос, обращение клиента или другая целевая операция?
- Какие требования к безопасности, размещению данных и доступности появятся при промышленном использовании?
После этого инфраструктурный разговор станет предметным — в проекте появятся реальная загрузка, стоимость месяца работы и прогноз роста.
Почему для пилота необязательно брать самый мощный GPU
Еще одна типичная ошибка заключается в стремлении сразу взять максимально производительную конфигурацию. Логика кажется разумной, ведь мощностей точно хватит, значит, эксперимент пройдет без ограничений. Однако такой пилот отвечает только на вопрос «Работает ли решение на дорогой инфраструктуре?». Для бизнес-эффекта этого мало.
Задача тестирования состоит еще и в поиске минимальной достаточной конфигурации. Если корпоративный ассистент хорошо работает на доступном GPU, использование дорогого ускорителя ухудшит юнит-экономику без дополнительной пользы пользователю. В связи с этим облачные вычисления на GPU удобны еще и возможностью сравнить несколько вариантов — сначала команда проверяет саму гипотезу, затем подбирает размер инфраструктуры под измеренную нагрузку.
Например, в GPU Cloud ITGLOBAL.COM для RTX PRO 6000 Blackwell Server Edition доступны vGPU-профили с 12, 24, 48 и 96 ГБ видеопамяти и конфигурациями от 4 до 24 vCPU и от 16 до 128 ГБ RAM. Для A100/A800 провайдер предлагает vGPU-профили на 10, 20, 40 и 80 ГБ.
Для новых клиентов провайдер также предоставляет тестовый период — это позволяет использовать аренду GPU для проверки проекта до решения о долгосрочной инфраструктуре.
Облако не значит, что весь проект придется оставить там навсегда
Выбор GPU Cloud для пилота не определяет архитектуру системы на следующие пять лет. После проверки гипотезы часть компаний действительно остается в облаке, ведь это удобно при растущей или неравномерной нагрузке, запуске нескольких ИИ-проектов одновременно и необходимости регулярно менять конфигурации.
Другим после выхода на стабильную загрузку выгоднее арендовать выделенный сервер с GPU. Такой вариант сохраняет отсутствие крупной первоначальной закупки, при этом ресурсы закрепляются за одним заказчиком. ITGLOBAL.COM, например, предлагает наряду с облачными GPU и выделенные GPU-серверы.
Третья группа в итоге приходит к собственной инфраструктуре. Обычно это происходит уже после того, как компания знает объем постоянной нагрузки, требования к оборудованию и экономику эксплуатации.
Облако в этой схеме работает как промежуточный этап принятия решения. Оно не требует заранее выбирать между «все свое» и «все облачное».
Когда собственный GPU-сервер действительно имеет смысл
У покупки есть свои сильные стороны — при высокой и предсказуемой загрузке собственная инфраструктура может оказаться экономически выгоднее аренды, но это нужно подтверждать расчетом полной стоимости владения. Она также может потребоваться компаниям с особыми требованиями к размещению данных, внутренним правилам безопасности или интеграции оборудования с существующим ЦОД. Но эти аргументы становятся убедительными после измерения нагрузки.
Если пилот показывает, что сервис будет постоянно занимать одни и те же мощности, число пользователей прогнозируемо, модель выбрана на несколько лет, а расчет полной стоимости владения оказывается выгоднее аренды, покупку уже можно рассматривать как инвестицию в работающий продукт. До этого момента компания фактически покупает прогноз.
Особенно осторожно стоит подходить к системам класса HGX. NVIDIA позиционирует HGX как платформу для наиболее требовательных задач искусственного интеллекта и высокопроизводительных вычислений, причем актуальные конфигурации объединяют сразу несколько мощных GPU. Это инфраструктура соответствующего масштаба, и ее приобретение логично тогда, когда нагрузка этого масштаба уже доказана.
Для типового корпоративного ассистента на несколько десятков пользователей инфраструктура класса HGX чаще всего будет избыточной, если только сценарий не требует запуска очень крупной модели, длинного контекста или других ресурсоемких вычислений.
Один из ключевых показателей после пилота — фактическая утилизация ускорителей. Если GPU нужны несколько часов в день или нагрузка возникает волнами, собственный сервер значительную часть времени будет простаивать, хотя капитальные и эксплуатационные расходы уже понесены. При постоянной загрузке ситуация меняется: чем выше полезная утилизация приобретенного оборудования, тем больше оснований сравнивать его TCO с долгосрочной арендой.
При расчете покупки стоит учитывать и инфраструктуру вокруг ускорителей. Для производительной системы могут потребоваться высокоскоростная сеть, NVMe-хранилище, резервирование, подходящие питание и охлаждение, размещение в ЦОД, мониторинг и специалисты, которые будут сопровождать драйверы, CUDA и платформенный стек. В итоге сравнивать цену сервера с месячным счетом облака напрямую некорректно — сопоставлять нужно TCO обеих моделей.
Сначала метрики, потом сервер
GPU-сервер сам по себе не делает ИИ-проект успешным — он лишь предоставляет вычислительную мощность для гипотезы, которую бизнес еще должен доказать.
Ранняя закупка оборудования же создает сразу несколько рисков. Компания фиксирует неизвестную пока конфигурацию, вкладывает капитальные затраты до появления экономического результата и принимает на себя риск быстрого обновления аппаратных платформ. Если пилот не взлетит, сервер останется, а если проект изменится, придется приспосабливать его к уже выбранной инфраструктуре.
Аренда GPU в облаке позволяет изменить порядок действий. Сначала компания запускает проект, проверяет его на реальных данных, измеряет нагрузку и считает экономику. После пилота уже станет понятно, какая модель эксплуатации подходит проекту: виртуальная машина с vGPU, зарезервированный облачный пул, выделенный GPU-сервер или собственная инфраструктура.