

97% российских компаний внедряют искусственный интеллект (ИИ), однако, по отчету Strategy Partners, положительные результаты получают менее 15%. Одним из главных препятствий для успешного внедрения ИИ являются некачественные данные, как следует из экспертного обсуждения на ПМЭФ. Какими должны быть данные для работы с ИИ и какие метрики позволяют определить эффективность внедрения, рассказал Денис Козицкий, лидер направления «Сбер2B ИИ».
 Более 60% российских компаний различных отраслей уже внедрили ИИ хотя бы в одну функцию, отмечают аналитики агентства «Яков и партнеры». При этом, по данным бизнес-группы «Сбер2B», готовность инвестировать в цифровизацию более 10% оборота выше у компаний, которые еще не внедряли ИИ: 17,6% против 6,9%. Это говорит о том, что после пилотных внедрений организации более осторожно подходят к дальнейшим инвестициям.
Внедрение ИИ может, например, обнаружить слабую культуру работы с данными в компании. Так, 10% предпринимателей планируют запуск чат-ботов без клиентской базы, а каждый пятый внедряет ИИ без системы управления взаимоотношениями с клиентами (CRM). В таком случае в компании нет единого центра работы с данными, а значит, они не могут быть использованы для аналитики или автоматизации продаж. В итоге ИИ не снижает нагрузку на сотрудников, а, напротив, усиливает хаос, создает дополнительное напряжение и постепенно подрывает доверие к технологии внутри компании.
Одно из наиболее заметных последствий низкого качества данных проявляется там, где ответ ИИ напрямую видит клиент или сотрудник, принимающий решение. Неточный ответ бота клиентской поддержки тут же может привести к жалобе или оттоку клиентов. Особой зоной риска является отдел кадров: ошибка в ответе про отпуск, больничный или премию создает репутационные и юридические риски для компании.
В работе юридического отдела и отдела комплаенса ИИ нельзя использовать на плохо размеченной базе без дополнительных механизмов проверки. Ошибка в ответе по нормативно-правовой информации может стоить компании штрафа. В отделе продаж ошибки менее критичны, но они напрямую влияют на конверсию. Например, ИИ-ассистент, который путает тарифы или условия, может привести к потере сделки.
Типичные проблемы с данными
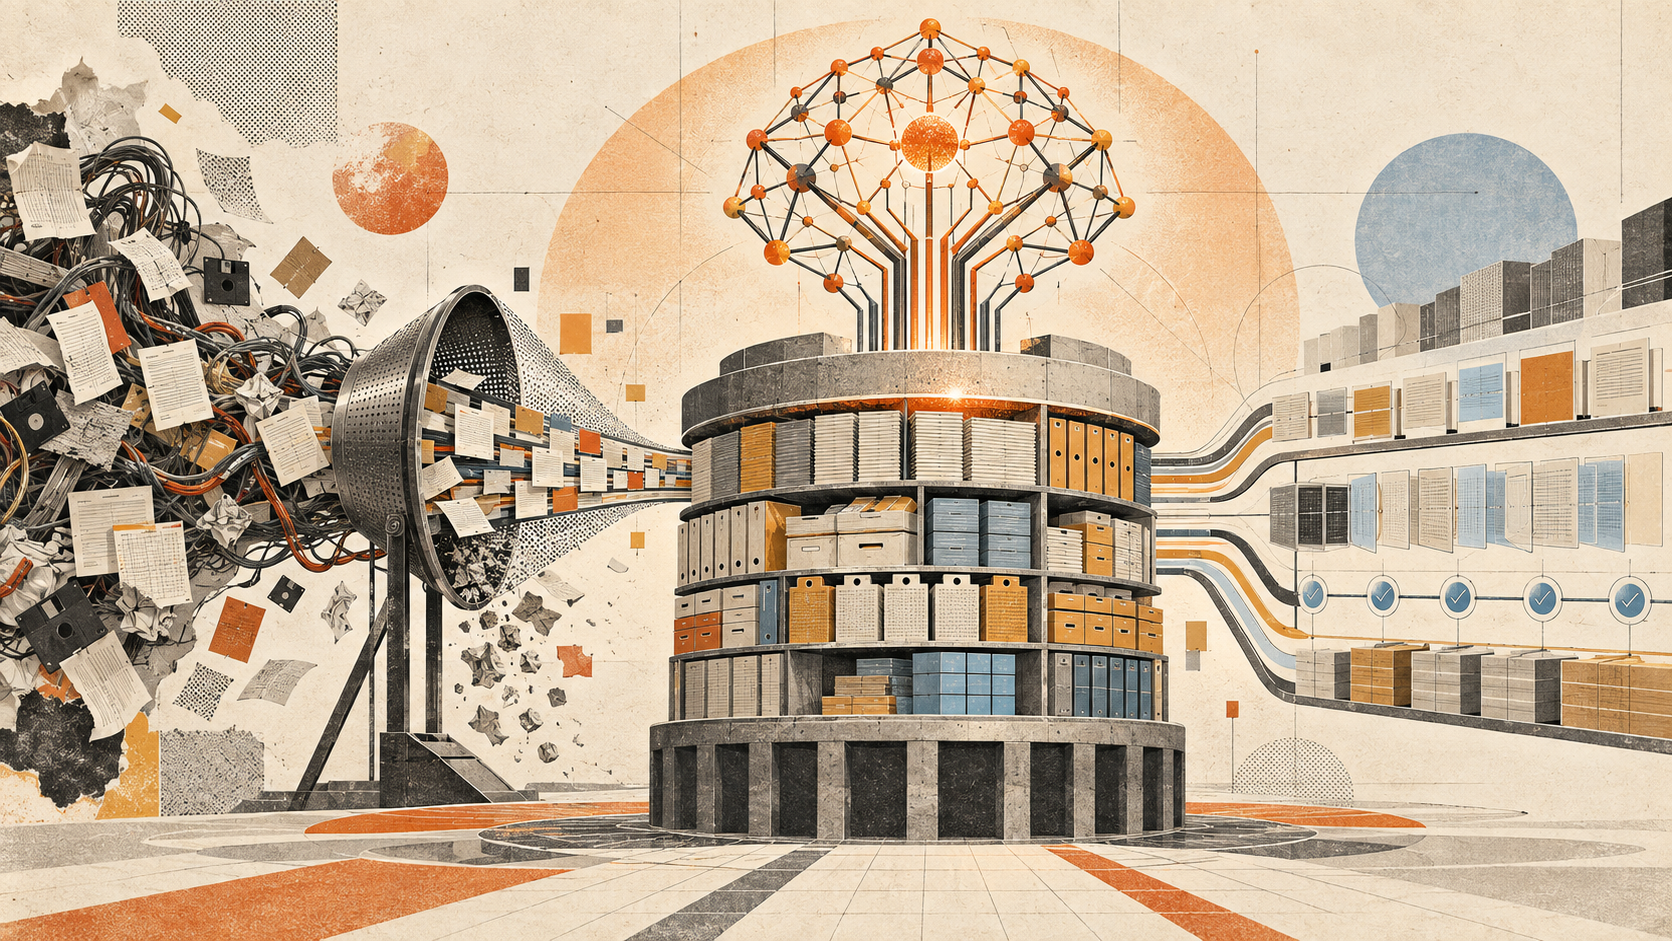
«Архивный хаос» — одна из самых распространенных ситуаций с хранением данных в компаниях. Документы копятся годами, у них нет владельцев, и никто не отвечает за их актуализацию. В результате в базе накапливаются данные, которые недостаточно качественны для работы с ИИ:
- дубликаты — например, одна и та же инструкция существует в трех версиях, которые немного отличаются друг от друга;
- противоречия между документами — например, регламент 2021 года говорит одно, а обновление 2024-го — другое, и оба документа остаются в базе;
- устаревшие данные — например, изменилась процедура, тарифы или законодательство, но информацию в базе не обновили;
- отсутствие единой терминологии — один и тот же продукт может называться по-разному в маркетинге, продажах и службе поддержки;
- разрозненность источников — часть информации хранится в CRM, часть — в онлайн-сервисах для работы с документами, часть — в личных папках сотрудников, а часть остается только у экспертов.
Когда с подобными данными работают сотрудники, они могут критически оценить информацию и при необходимости собрать полную картину. ИИ же может не отличить актуальную версию документа от устаревшей и выдать неверный ответ.
Степень готовности данных к внедрению ИИ часто отличается в разных отделах. Наиболее качественными обычно бывают FAQ и продуктовые описания, потому что они находятся на виду и регулярно проверяются маркетингом. База службы поддержки может выглядеть лучше остальных, но типичная проблема этого отдела в том, что статьи написаны «для своих», без учета того, как формулируют вопросы клиенты.
Хуже всего обстоят дела с данными, которые считаются «внутренней кухней» — операционными инструкциями, чек-листами и регламентами согласований. Обычно эти материалы объемные, написаны юридическим языком, плохо структурированы и редко актуализируются.
Проблемы с качеством данных характерны и для скриптов продаж, и для материалов менеджеров. Информация распределена между презентациями, чатами и переписками, поэтому у каждого продавца формируется своя «золотая» версия. HR-документы тоже находятся в зоне риска: политики обновляются, но старые версии не удаляются, а сотрудники задают вопросы именно по актуальной редакции.
Как подготовить базу данных для работы с ИИ
Главный критерий данных, достаточно качественных для работы с ИИ, — наличие единой канонической версии информации. Речь идет о создании в компании единого источника «правды»: для каждой сущности, будь то политика, процедура или описание продукта, должна быть определена актуальная версия документа.
Если на один вопрос в базе содержатся три разных ответа, ИИ может выбрать не тот, который является правильным, а тот, который окажется наиболее релевантным по имеющимся данным. Поэтому важно не только собрать информацию, но и определить, какая версия является канонической.
Такая система задает точку ответственности. У каждого канонического документа должен быть владелец, который отвечает за его актуальность. Без этого база живет по принципу «общего двора»: все пользуются, но никто не следит за порядком.
Кроме того, наличие канонических версий делает возможным аудит. Когда ИИ выдает некорректный ответ, можно проследить, на какие данные он опирался, и устранить причину ошибки.
Для быстрой оценки готовности базы данных к внедрению ИИ можно провести практический тест. Возьмите 30–50 реальных пользовательских вопросов и попробуйте найти на них ответы в базе вручную. Если более чем на 80% вопросов вы находите один однозначный ответ за разумное время, база относительно зрелая. Если приходится сверять несколько документов и звонить эксперту, сначала стоит заняться культурой работы с данными.
Подготовка базы. Основные шаги
1. Провести инвентаризацию источников знаний
Соберите их в единый каталог. Сначала нужно понять, что именно есть в компании: где хранится контент, в каких системах, какого он объема и кто им владеет.
2. Начать с одного-двух сценариев с наибольшей ценностью
Не стоит пытаться привести в порядок всю базу одновременно. Лучше начинать с отделов, где есть высокая частота обращений и измеримый бизнес-эффект.
На практике это обычно клиентская поддержка, отвечающая на типовые вопросы, и внутренний HR-помощник. Также можно начать с онбординга новых сотрудников или продуктовой базы для продаж, содержащей актуальные характеристики, сравнения с конкурентами и типовые возражения.
Не стоит начинать с регламентов комплаенса или сложных юридических процедур. Там высока цена ошибки, а частота запросов может быть небольшой. В результате окупаемость инвестиций (ROI) будет низкой, а риски — высокими.
Принцип простой: начинать с массовых, но не критичных сценариев, оценивать точность и устойчивость результатов и только потом расширяться в сторону регулируемых процессов.
3. Назначить владельцев данных
У каждого раздела и ключевого документа должен быть ответственный. Без этого компании придется регулярно перепроверять актуальность всех данных вручную.
4. Определить канонические версии и убрать дубли
Неактуальные документы можно удалить или перенести в архив, чтобы они не использовались ИИ при формировании ответа.
5. Привести документы к единому формату
Документы лучше называть по вопросу или задаче, которую они решают, а не условно «Регламент 4.2.7». Тексты стоит писать по единому шаблону: заголовок-вопрос, краткий ответ в первом абзаце, подробности дальше, а в конце — связанные документы и информация о владельце.
Важно придерживаться принципа «один документ — одна тема». Вместо «Полного гайда по работе с клиентами» на 80 страниц лучше создать 20 отдельных материалов. Это особенно важно для ИИ, так как современные модели извлекают из базы отдельные фрагменты, и чем точнее фрагмент соответствует конкретной теме, тем выше вероятность корректного ответа.
6. Разработать единый глоссарий
Создайте словарь терминов и отдельный словарь синонимов. Это особенно актуально для продуктовых названий и внутренних терминов.
Важно, чтобы одно понятие называлось одинаково во всех документах, а используемые синонимы были зафиксированы отдельно. Перекрестные ссылки между связанными документами также помогают модели лучше учитывать контекст.
7. Добавить метаданные
Для каждого файла стоит указать его тематику, аудиторию, дату актуализации и владельца. Эти характеристики помогают системам корректнее работать с массивом документов.
8. Настроить регулярный пересмотр данных
Ревизию наиболее критичных разделов рекомендуется проводить не реже одного раза в квартал.
9. Определить уровни доступа
Необходимо разграничить доступ к данным и отдельно пометить чувствительный контент.
10. Настроить логирование
Изменения в документах и настройках должны фиксироваться в системе, чтобы при необходимости можно было восстановить историю изменений.
После этого можно пилотировать ИИ на узком сценарии и измерять качество ответов до масштабирования. Условно можно считать, что технологии решают около 30% задачи подготовки. Остальные 70% — это процессы и люди.
Какие метрики показывают эффект
До запуска ИИ нужно зафиксировать базовый уровень метрик, по которым в дальнейшем будет оцениваться эффективность внедрения.
Метрики клиентской поддержки
В минимальный набор входят:
● среднее время ответа на типовой запрос;
● среднее время разрешения обращения (time-to-resolution);
● доля обращений, требующих эскалации;
● число обращений на одного сотрудника поддержки в день;
● доля обращений, решенных при первом контакте (FCR);
● индекс удовлетворенности клиентов (CSAT);
● число повторных обращений по одному вопросу.
Для внутренних ИИ-помощников стоит учитывать время, которое сотрудник тратит на поиск нужной информации, и долю вопросов, по которым он обращается к коллеге вместо использования базы. Эти показатели можно измерять с помощью опросов.
Метрики самой ИИ-системы
После внедрения добавляются показатели качества работы системы:
● доля запросов, на которые найден корректный ответ в базе;
● доля запросов с эскалацией к человеку;
● средняя оценка ответа пользователем;
● доля жалоб на бота;
● доля запросов, на которые ИИ отвечает «не знаю».
Последний показатель позволяет оценивать «честность» системы. Снижение доли ответов «не знаю» при сохранении высокой точности ответов может свидетельствовать о том, что база действительно совершенствуется.
Бизнес-метрики
Для руководства наиболее показательны метрики, связанные непосредственно с бизнес-эффектом. В поддержке это time-to-resolution — время от регистрации проблемы до ее решения, deflection rate — доля обращений, закрытых без участия оператора, CSAT и нагрузка на сотрудников.
В продажах можно отслеживать конверсию. На старте пилота наиболее убедительными обычно являются deflection rate и CSAT в поддержке: их относительно легко измерить, и изменения становятся заметны быстрее.
Также стоит отслеживать скорость обработки запросов и сокращение числа ошибок, хотя эти показатели менее очевидны с точки зрения финансового эффекта. Конверсия в продажах — более сложная метрика для пилота, поскольку ее трудно очистить от влияния внешних факторов. Однако если она растет, это становится сильным аргументом для руководства.
Обычно первые измеримые эффекты в deflection rate и скорости ответа видны через 4–8 недель после запуска, если речь идет о пилоте на узком сценарии, например об ИИ-помощнике в поддержке по одному продуктовому направлению.
Эффекты в CSAT и нагрузке на сотрудников проявляются медленнее — через 2–4 месяца. За это время нужно накопить статистику и пройти период адаптации пользователей к системе.
Бизнес-эффекты в конверсии продаж или удержании клиентов проявляются на горизонте 6–12 месяцев. Если же компания пытается запустить ИИ без предварительной подготовки базы, эффект в первые месяцы может оказаться отрицательным, например, растет число жалоб, снижается CSAT, сотрудники начинают меньше доверять системе. В связи с этим экономика проекта должна выглядеть следующим образом: 2–4 месяца на подготовку базы, 1–2 месяца на запуск пилота, а уже после этого — этап масштабирования и выхода на окупаемость.
Попытки сократить этап подготовки часто приводят к необходимости вернуться к нему через несколько месяцев, но уже с потерянным доверием к технологии внутри компании. Именно поэтому проблема окупаемости ИИ-проектов не всегда связана с качеством моделей. Если фундамент в виде данных, процессов и ответственности не подготовлен, даже хорошая технология не даст ожидаемого эффекта.