



«Классические суперкомпьютерные центры (HPC) в их нынешнем виде исчерпают себя в течение пяти лет. Граница между научными расчетами и обучением больших языковых моделей размывается, а единый GPU-пул становится экономической необходимостью. При этом ключевой барьер на пути к универсальному кластеру лежит не в плоскости «железа», а в плоскости программной оркестрации», — полагает директор Управления продуктов и технологий компании «Е-Флопс» Сергей Плюснин. Эксперт помогает разобраться, что будет дальше.
Фундаментальные различия
В современных условиях потребность бизнеса и науки в вычислениях продолжает расти, и сам принцип организации инфраструктуры меняется. Исследовательские группы все чаще используют модели машинного обучения для ускорения расчетов, а ИИ-команды нуждаются в тех же ускорителях, сетях и хранилищах, что и классический HPC.
Держать два отдельных кластера — с разным оборудованием, разными командами и разным программным обеспечением — становится экономически невыгодно.
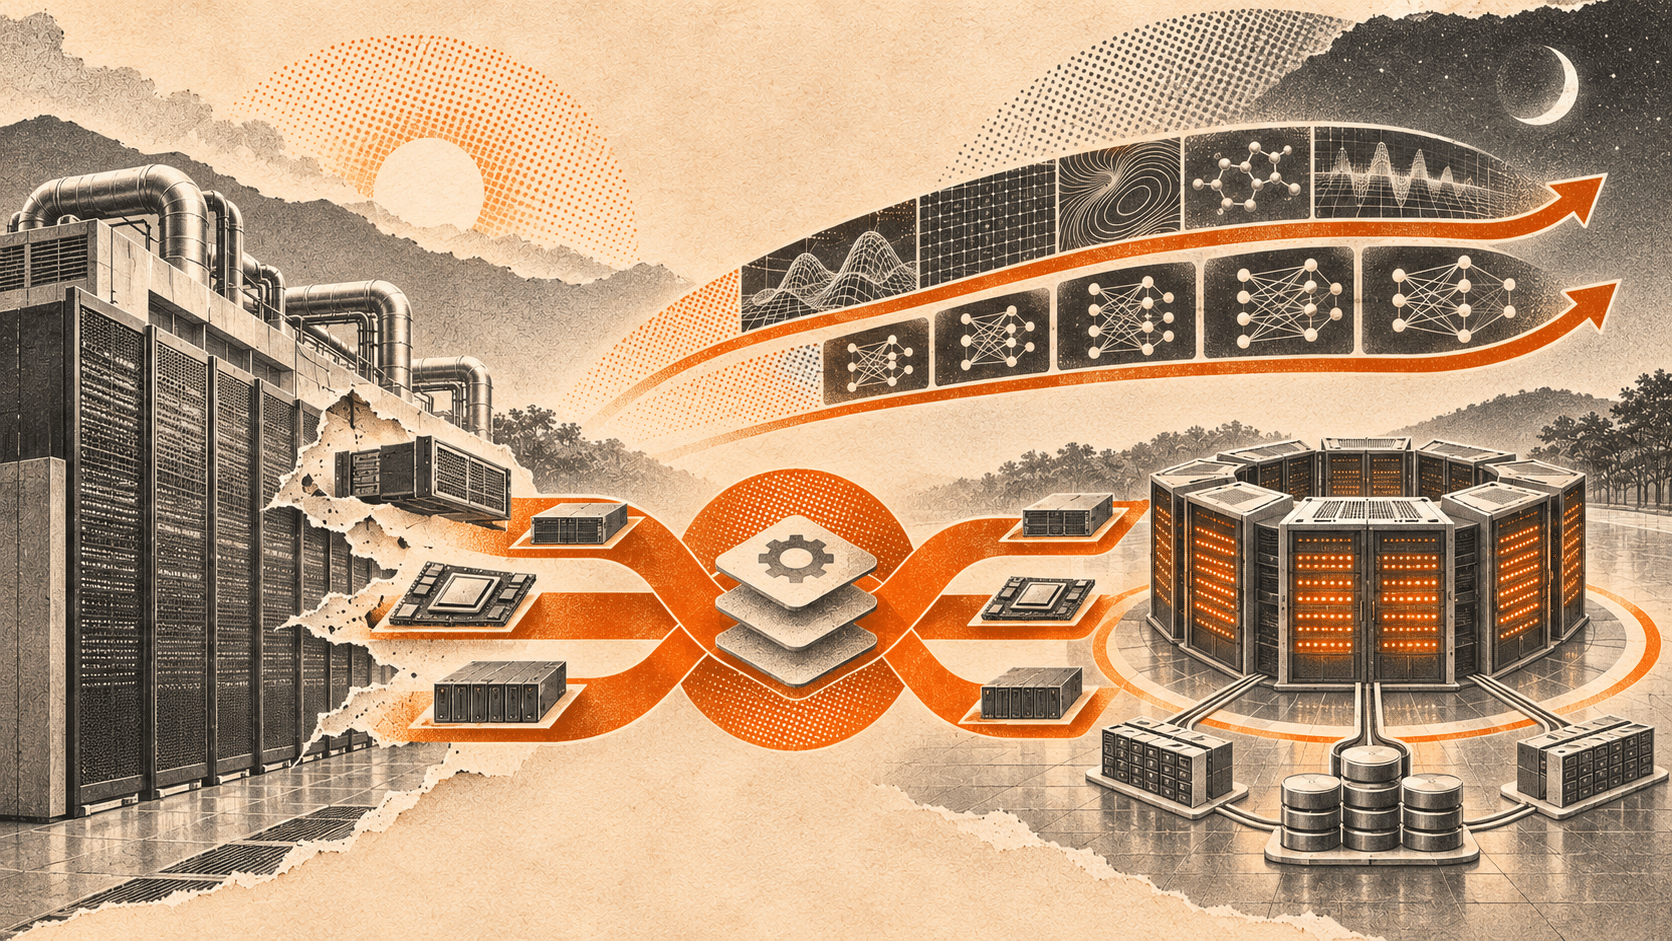
Пятилетний горизонт — это срок, за который нынешнее поколение суперкомпьютерных центров выработает ресурс, а новое будет строиться уже с осознанием невозможности универсального «железа». Причина тому — фундаментальные различия в характере вычислений, которые невозможно устранить на уровне оборудования.
HPC работает с высокой точностью вычислений, так как расходимость за миллион итераций недопустима. Задачи ИИ допускают пониженную точность вычислений ради пропускной способности специализированных ускорителей. Различаются и профили нагрузки:
- HPC ограничен скоростью доступа к памяти и производительностью процессора;
- AI — пропускной способностью памяти и сети.
Именно поэтому универсальное «железо» в текущих условиях невозможно. Один и тот же узел не может одинаково эффективно обслуживать оба класса задач.
Задача уже решена
Задача реализации универсальной оркестрации при этом уже решена. В основе ее решения — два планировщика, которые работают на одном пуле GPU-узлов и не мешают друг другу.
Slurm отвечает за пакетные задачи, например, научные расчеты и обучение моделей. Kubernetes напрямую управляет сервисами, которые работают постоянно — в первую очередь инференсом (то есть работой уже обученных моделей).
Каждый планировщик знает, какие узлы заняты «соседом», и не трогает их. Slurm не берет ноды, отданные под инференс, а Kubernetes не ставит свои задачи на узлы, занятые пакетным заданием. Размер ночного окна определяется профилем инференса: днем GPU работают на сервис, ночью — на дообучение моделей и эксперименты.
Такой подход позволяет отказаться от двух параллельных наборов инструментов и перейти к единому. Slurm в Kubernetes получает отказоустойчивость «из коробки». Если управляющая программа Slurm дает сбой, Kubernetes автоматически запускает ее заново.
Конфигурация описывается декларативно, а любое изменение сохраняется в истории версий, откат выполняется одной командой.
Аргументы и факты
Главный аргумент в пользу зрелости такого подхода — наличие продакшен-решений:
- Soperator от Nebius — готовый инструмент для развертывания Slurm в Kubernetes, который добавляет общую файловую систему для мгновенного обновления программных компонентов, проверки GPU, дисков и сети с автоматическим выводом узла из работы и переиспользование GPU между обучением и инференсом.
- SUNK от CoreWeave — еще один готовый инструмент для запуска Slurm в Kubernetes. Он синхронизирует состояние контейнеров и узлов в обе стороны, автоматически строит топологию из меток Kubernetes и выявляет отстающие GPU в многоузловом обучении.
Оба решения работают в продакшене на тысячах GPU. Для гибридных сценариев, когда Slurm уже существует рядом с Kubernetes, предусмотрен переходный механизм slurm-bridge. Стандартная задача, запущенная в Kubernetes, превращается во временное задание для Slurm, тот выделяет физические узлы и возвращает их обратно. Ограничение — сервер не делится между несколькими задачами, поэтому такой вариант не подходит для плотного инференса с разделением GPU.
При этом универсальность не является обязательным требованием. Когда ИИ не используется и требуется только HPC — оптимален классический Slurm на «голом железе».
Для пакетных задач в Kubernetes с очередями достаточно стандартных средств управления. Для команд, которые занимаются только ML, хватит платформы Ray, запущенной в Kubernetes. Slurm в Kubernetes оправдан именно для сценария, когда HPC, обучение моделей и инференс должны работать на одном пуле оборудования.
Главный вызов
Универсальное железо невозможно — HPC и AI расходятся в точности, сетевом профиле и паттерне хранилища. Но вопрос построения универсальной оркестрации закрыт, так как есть Slurm в Kubernetes на базе открытого проекта Slinky и готовых решений, таких как Soperator.
Главный вызов — не железо, а софт, оркестрация и культура совместного использования на одном пуле. Вопрос, который остается перед каждой организацией: «Нужен ли ей именно единый пул или экономически эффективнее создать два раздельных контура?». Ответ на него лежит в области оценки временных графиков нагрузок HPC и AI — чем слабее их перекрытие, тем выше отдача от универсализации.
Читайте также: