

24 сентября MLCommons объявила о запуске первого отраслевого бенчмарка для посттренинга LLM в рамках MLPerf Training v6.1. Новый тест оценивает эффективность reinforcement learning (RL) при обучении языковой модели с 397 млрд параметров. Особое внимание уделяется масштабированию распределенной инфраструктуры, синхронизации весов и балансу между производительностью и качеством обучения. Появление такого бенчмарка показывает, что RL-обучение больших моделей стало отдельной инженерной задачей со своими узкими местами.
Об этих особенностях мы поговорили с Дмитрием Улюмджиевым, исследователем в области посттренинга в Reflection. До этого он работал в xAI над RL-обучением reasoning-моделей Grok — там он построил RLDB v2, буфер данных, который позволил масштабировать связку акторов и трейнеров до порядка 10 000. Кроме того, его работа над синхронизацией весов помогла вчетверо снизить KL-дивергенцию при обучении. В интервью — об архитектурных ограничениях reasoning-моделей и о том, как масштабировать RL-системы.
 — Какие технические ограничения в основном возникают при масштабировании обучения с подкреплением для современных reasoning-моделей?
На этапе предварительного обучения (pre-training) часто говорят о «подъеме по лестнице масштабирования». Улучшения, выглядящие многообещающе в небольших экспериментах, не всегда сохраняют эффективность при переходе к более крупным моделям. В обучении с подкреплением (RL) эта задача усложняется, и речь идет не только о размере модели, но и об объеме и разнообразии обучающих задач, алгоритме оптимизации и инфраструктуре.
Подход, который хорошо работает в малом масштабе, при его увеличении может стать нестабильным или неэффективным. Кроме того, actors — экземпляры модели, генерирующие попытки решения задач, — должны быть скоординированы с trainers так, чтобы генерация решений (rollouts), обновление модели и синхронизация весов оставались сбалансированными.
Одна из проблем, с которой мне приходилось сталкиваться неоднократно, — в процессе обучения длительность рассуждений модели может существенно меняться. Это нарушает баланс между сбором данных и обучением, ведь trainers могут простаивать в ожидании новых данных, либо actors могут создавать избыточный объем данных, полученных с помощью устаревших версий модели.
При масштабировании такие проблемы усугубляют друг друга. Изменение поведения модели превращается в проблему планирования процессов, которая, в свою очередь, перерастает в проблему оптимизации.
— Как устроено взаимодействие actors и trainers в распределенном RL и что чаще всего ограничивает производительность таких систем?
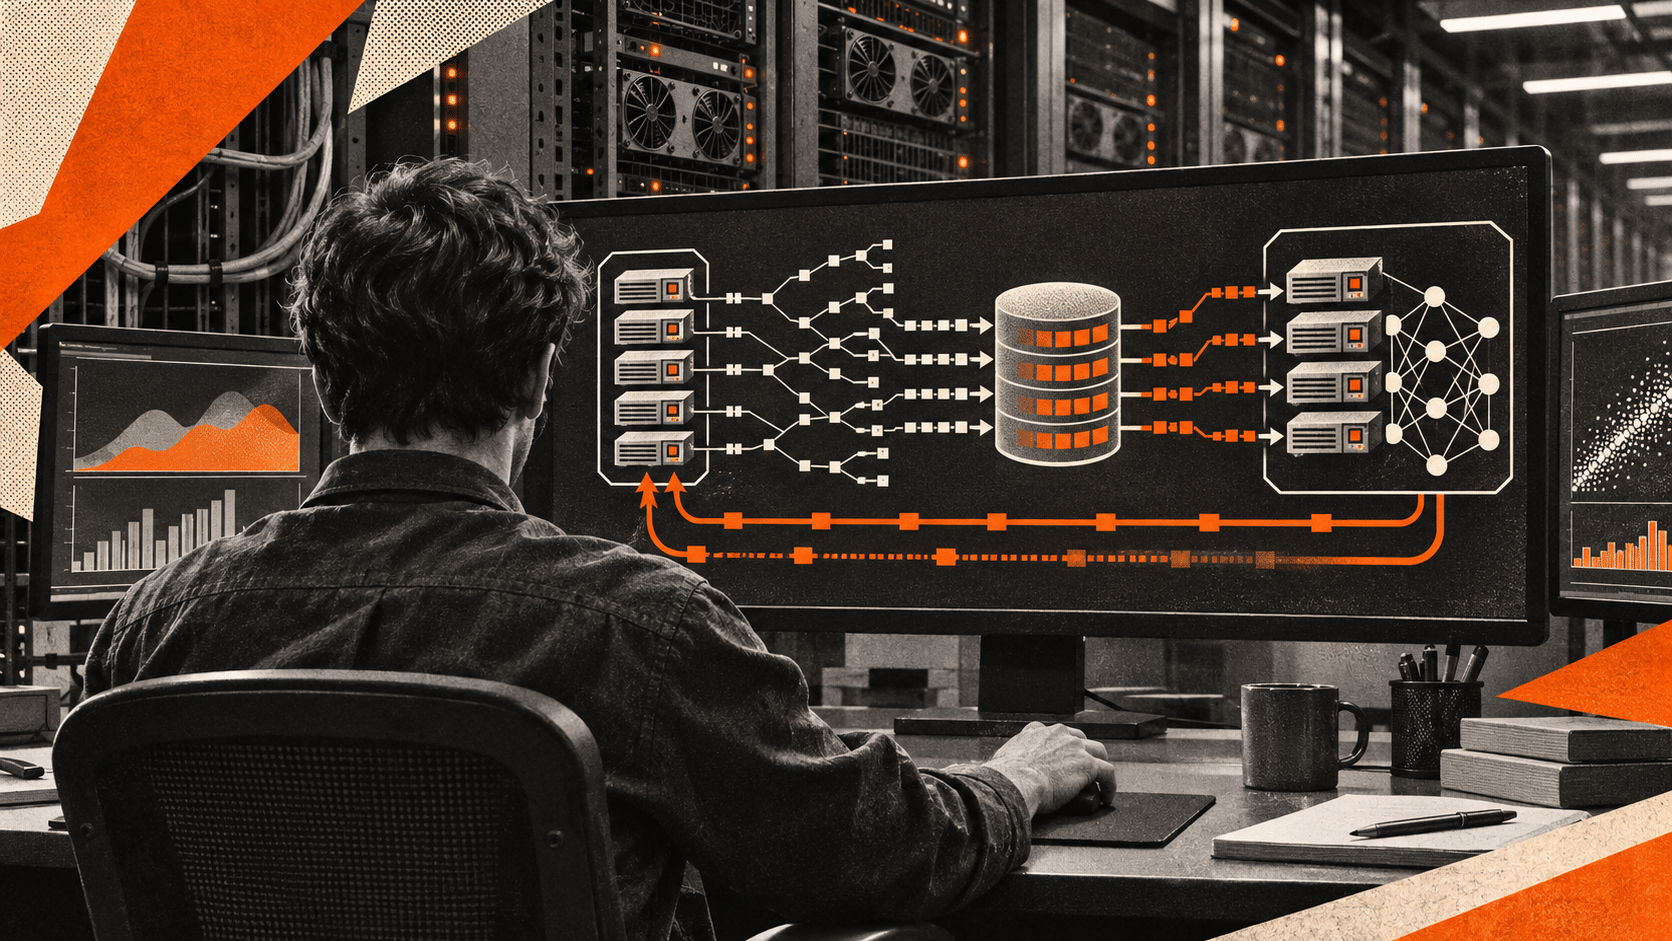
В индустрии сложился подход, при котором actors и trainers в значительной степени отделены друг от друга. Это так называемое асинхронное обучение с подкреплением (asynchronous RL). Отдельные экземпляры больших языковых моделей генерируют как можно больше траекторий (rollouts), а trainers обрабатывают их, выполняют градиентное обновление весов и передают обновленные веса акторам. Такая архитектура критически важна для масштабирования RL на десятки и даже сотни тысяч GPU.
Представьте, что одно решение задачи по программированию занимает 500 КБ текста. Если для задачи делается 100 попыток, а для одного градиентного шага требуется около тысячи задач, то только сами решения займут 50 ГБ. А поскольку градиентных шагов нужны тысячи, для хранения этой информации требуются петабайты.
Разделение тренеров и акторов дает огромное преимущество — отказоустойчивость. Для нас с вами неисправности GPU — редкое явление, но в кластерах из 100 тысяч GPU они случаются ежедневно. Поскольку RL может длиться неделями или месяцами, способность системы продолжать работу при сбоях критически важна.
Как правило, между тренерами и акторами существует координатор и буфер данных (data buffer), передающий траектории тренерам в виде батчей (batches). Поскольку эту систему сложно шардировать, она зачастую становится «единой точкой отказа». Если буфер выходит из строя, весь процесс обучения останавливается, что приводит к огромным операционным издержкам.
— Какую роль играют высокопроизводительные data buffers и какие архитектурные решения позволяют масштабировать их до тысяч параллельных workers?
Буферы данных выполняют две основные задачи:
- управление процессом обучения (curriculum control) — путем выбора наборов заданий для акторов;
- сбор результатов в батчи, на которых модель учится на своих ошибках.
Для этого нужно знать состояние всей системы, например, какие батчи уже обработаны, какие задания уже пытались выполнить, над чем идет работа сейчас и т. д.
Такие буферы должны быть предельно надежными и обычно реализуются на низкоуровневых языках (например, C или Rust). Грамотно спроектированный буфер способен справляться с сотнями тысяч операций благодаря передовым сетевым файловым системам, компактным механизмам RPC и эффективным алгоритмам планирования и упаковки данных.
Например, одной из задач, которую мне пришлось решать в xAI, было размещение состояния data buffer в оперативной памяти. До определенного момента мы без труда хранили все состояние обучения в RAM, что позволяло очень быстро вносить изменения. Однако при масштабировании до 10 000 GPU стало очевидно, что необходимо либо шардировать буфер, либо оптимизировать использование памяти.
Ситуация осложнялась тем, что иногда нам приходилось запускать обучение на серверах всего с 500 ГБ RAM — против 2 ТБ в наиболее производительных дата-центрах. Ключевым элементом решения стала сетевая файловая система (NFS), обеспечившая всем компонентам доступ с низкой задержкой и высокой пропускной способностью. Нашему буферу пришлось в кратчайшие сроки перейти на NFS, причем максимально эффективно — за счет параллелизма, конкурентности и оптимизированного низкоуровневого кода.
— Почему при асинхронном обучении возникает policy staleness и как устаревшие rollout-данные влияют на стабильность оптимизации?
Если бы тренеры и акторы никогда не синхронизировали веса модели, rollouts стали бы практически бесполезными, поскольку они имели бы разное представление о том, какая модель оптимизируется.
По этой причине крайне важно синхронизировать веса как можно быстрее и чаще, чтобы минимизировать «устаревание стратегии» (policy staleness) — показатель того, насколько веса акторов отстают от актуальной версии модели. Однако акторы, как правило, не начинают генерацию заново, а обновляют веса «на лету» и продолжают работу. В результате часть данных оказывается получена с помощью не самой актуальной версии модели — такова плата за высокую пропускную способность.
Если устаревание слишком велико, rollouts содержат крайне мало полезных сигналов: мы хотим, чтобы модель училась на собственных ошибках, а не на примерах работы другой версии модели. На практике большинство алгоритмов RL в таком случае теряют устойчивость, что полностью ломает модель и требует отката к предыдущей версии. Такие события могут стоить десятки или даже сотни миллионов долларов, потраченных на GPU-часы.
— Какие сложности возникают при синхронизации весов между actors и trainers и как минимизировать training–inference mismatch?
Синхронизация весов должна обеспечивать плавный переход без прерывания обучения и учитывать топологию сети. Объем весов передовых моделей может исчисляться терабайтами, однако современные системы синхронизируют их за десятки секунд. Один из приемов, который я неоднократно применял, — передавать лишь разницу между новыми и старыми весами: эмпирически доказано, что при RL веса обновляются разреженно.
Кроме того, синхронизация должна происходить незаметно для акторов. Для загрузки новых весов обычно приходится задействовать вычислительные блоки GPU (например, SM у NVIDIA) — крайне ценный ресурс, поэтому часть работы перекладывают на CPU, а технология RDMA ускоряет передачу данных, соединяя GPU напрямую.
Одна из проблем, с которой мне приходилось сталкиваться, — для быстрой синхронизации у акторов должны быть свободные ресурсы CPU и RAM. Однако, когда акторам приходится передавать большие объемы вспомогательной информации, эти ресурсы оказываются заняты обработкой структур данных. Такие проблемы очень трудно обнаружить, видя лишь замедление синхронизации весов.
Центральной метрикой и для training-inference mismatch, и для policy staleness является KL divergence (дивергенция Кульбака–Лейблера) между тренером и актором — простая метрика, очень чувствительная к любым систематическим расхождениям. Один из примеров mismatch — различия на уровне ядер CUDA. Код для GPU при обучении и при выводе зачастую различается, из-за чего одна и та же модель может выдавать разные результаты.
— Как training KL divergence помогает выявлять проблемы синхронизации и оценивать эффективность инженерных изменений?
Один пример, с которым мне приходилось сталкиваться, — «маршрутизация экспертов» (expert routing) в mixture-of-experts моделях, которые динамически выбирают нужные модули-«эксперты» в зависимости от входных данных. Проще говоря, модель может задействовать «эксперта по математике», когда ей нужно решить математическую задачу. Этот подход стал де-факто стандартом в современных reasoning-моделях.
Поскольку это дискретное решение, оно может меняться даже из-за незначительных численных расхождений. Модули обучения и вывода могут выбирать разных экспертов, даже когда policy staleness полностью отсутствует.
Одно из решений, ставшее отраслевым стандартом, — «воспроизведение маршрутизации экспертов» (expert routing replay). Мы записываем выбор, сделанный акторами, и принудительно используем его на этапе обучения. Реализовать это корректно и эффективно непросто, но метод очень часто существенно уменьшает KL divergence.
Многие команды обнаружили большие скачки KL divergence при переходе от dense-трансформеров к mixture-of-experts моделям, что привело к обнаружению многих подобных проблем.
— Какие изменения в архитектуре распределенного RL могут сделать обучение reasoning-моделей более эффективным в ближайшие годы?
Полагаю, со временем мы неизбежно перейдем к более сложным методам — как на высоком, так и на низком уровне. Например, Google обучала свои модели на нескольких небольших кластерах в одном регионе, тогда как остальная индустрия традиционно предпочитала один крупный дата-центр.
Думаю, в будущем придется задействовать сразу несколько кластеров, поскольку физически разместить в одном столько GPU, сколько нужно для следующего этапа масштабирования, будет невозможно. Для этого потребуется новое поколение алгоритмов и инфраструктуры, способных эффективно работать даже при сильном устаревании стратегий.
На низком уровне мы только начинаем разбираться, насколько эффективно можно производить inference для акторов. Думаю, именно здесь произойдет множество инженерных прорывов, которые могут открыть путь к следующему поколению reasoning-моделей. Область reasoning RL существует всего около двух лет, так что я ожидаю еще очень много больших изменений.
Термины из интервью
Post-training — этап дополнительного обучения уже предварительно обученной модели. На нем модель донастраивают под конкретное поведение, задачи и способы рассуждения.
Reinforcement learning, RL — обучение с подкреплением. Модель учится на обратной связи, получая сигнал о том, насколько хорошо она выполнила задачу.
Reasoning-модель — модель, рассчитанная на решение задач, требующих последовательного рассуждения, например математики, программирования или логического анализа.
Pre-training — первоначальное обучение модели на больших массивах данных, в ходе которого она получает базовые знания и языковые навыки.
Actors — экземпляры модели, которые выполняют задания и генерируют варианты решений во время RL-обучения.
Trainers — компоненты системы, которые используют полученные от actors данные для обучения и обновления весов модели.
Rollouts — последовательности действий или решений, сгенерированные моделью при выполнении задачи. На них система затем учится.
Asynchronous RL — архитектура, при которой генерация данных actors и обучение trainers происходят параллельно и не требуют постоянной синхронизации каждого шага.
Data buffer — промежуточное хранилище между actors и trainers. Оно собирает результаты работы модели, распределяет задания и формирует данные для обучения.
Batch — набор примеров, который обрабатывается моделью за один шаг обучения.
Policy staleness — «устаревание стратегии». Возникает, когда actors продолжают генерировать данные на старой версии модели, пока trainers уже обучают более новую.
Training–inference mismatch — расхождение между поведением модели во время обучения и при генерации ответов. Даже одна и та же модель может работать немного по-разному из-за особенностей вычислений.
KL divergence — метрика, показывающая, насколько отличаются два распределения вероятностей. В распределенном RL помогает заметить рассинхронизацию между trainers и actors.
Mixture-of-Experts, MoE — архитектура, в которой модель состоит из множества специализированных модулей-«экспертов» и для каждого запроса активирует только часть из них.
Expert routing — механизм выбора тех «экспертов» MoE-модели, которые будут обрабатывать конкретные данные.
Expert routing replay — подход, при котором выбор экспертов, сделанный во время генерации, записывается и затем воспроизводится во время обучения, чтобы уменьшить расхождения.
Inference — работа уже обученной модели непосредственно при генерации ответа.
RDMA — технология прямой передачи данных между устройствами с минимальным участием CPU. В больших GPU-кластерах помогает быстрее передавать веса модели.