



За годы работы с enterprise-проектами мы выработали подход к мониторингу, который позволяет отлавливать инциденты до того, как о них напишет клиент. В этой статье Сергей Суханов, основатель и CEO компании «Триада», рассказывает о том, как работает наша методология. Без привязки к конкретному стеку, но с реальными цифрами и лайфхаками, которые можно применить.
 Дашборды зеленые, CPU в норме, память свободна, диски не переполнены, а заказчик звонит и сообщает, что у него ничего не работает. Серверы живы, но бизнес стоит — классика.
На одном проекте интернет-магазина у нас был показательный кейс. Вечер, пиковая нагрузка, мониторинг инфраструктуры молчит — все сервисы отвечают, коды 200-е, а пользователи не могут оформить заказ, потому что не выбирается адрес доставки. Оказалось, что боты съели суточные лимиты API сервиса подсказок адресов. Лимит был на условный миллион запросов, и к концу дня он закончился. Система не упала, серверы не перегрелись, но ключевая бизнес-функция перестала работать.
Если бы мы мониторили только железо, о том, что сервис фактически не работает, мы узнали бы от заказчика, а он — от своих клиентов, партнеров или инвесторов. То есть мы всегда узнавали бы о проблеме даже не вторыми — третьими.
Две сущности: метрики и события
Когда говорят про мониторинг, часто путают две принципиально разные вещи:
- Метрики — любые количественные данные. Например, процент нагрузки процессора, свободное место на диске, количество SMS, отправленных за час, время ответа конкретного метода, длина очереди. Все, что можно измерить и отобразить на графике.
- События — состоявшиеся факты. Например, попытка авторизации провалилась, заказ создан, очередь в RabbitMQ превысила порог. События фиксируются в логах и требуют поиска по тексту.
Под каждую сущность мы используем свой стек. Для метрик — Prometheus + Grafana, а для логов — ELK (Elasticsearch, Logstash, Kibana).
Установить Grafana можно за две минуты, это задача для любого девопса, но без настроек она практически бесполезна. По умолчанию Grafana показывает серверные метрики — CPU, RAM, диск, сеть, процент ошибок балансировщика. По ним видно, что серверу плохо, но непонятно почему.
Метрики и логирование нужны не для того, чтобы констатировать факт «серверу плохо», а для того, чтобы знать причину.
Я не один год повторяю командам мантру: «Grafana — это такой же цифровой продукт. Ее конфигурации должны лежать в Git, изменения должны идти через пул-реквесты и раскатываться как код. Веб-интерфейс «Графаны», где админ расставил галочки, — не мониторинг, мониторинг не в Git — тоже не мониторинг. Это локальный эксперимент, который умрет вместе с уволившимся админом».
Мониторинг ИТ-инфраструктуры с Prometheus и Grafana
Первое, что мы делаем на любом проекте — инвентаризируем подсистемы, то есть разбираем, из чего состоит продукт. Обычно это стандартный набор служб:
- Физические серверы или виртуалки.
- Балансировщики нагрузки (nginx, HAProxy).
- Базы данных (PostgreSQL, MySQL).
- Кэширующий слой (Redis, Memcached).
- Интерпретатор бэкенда (PHP-FPM, Go, Java).
- Планировщики очередей (RabbitMQ, Kafka).
Под каждую из этих служб существуют готовые шаблоны мониторинга. Для Redis — процент попадания в кэш, процент заполнения памяти, скорость вытеснения ключей. Если процент попадания низкий — скорее всего, разработчик не предусмотрел правильные ключи кэширования или у вас слишком разрозненный профиль данных.
Для RabbitMQ — длина очередей, количество unconsumed messages. Для балансировщика — распределение кодов ответа.
Начинать нужно именно с этого — накатить boilerplate-шаблоны под каждую службу, посмотреть на реальные графики, понять, что из этого действительно нужно, а что только создает шум. Это закрывает 80% системных проблем первого месяца.
Технически Prometheus собирает метрики через экспортеры — небольшие агенты, каждый из которых отвечает за свою часть инфраструктуры. В нашем стандартном наборе пять штук:
- node_exporter — CPU, память, диски, сеть. Базовое здоровье сервера.
- apache_exporter — статусы воркеров, количество запросов, время ответа.
- php-fpm_exporter — пул процессов PHP: сколько активных, сколько в очереди, сколько простаивает.
- mysql_exporter — запросы к базе, uptime, slow queries, размер буферов.
- memcached_exporter — попадания в кэш, использование памяти, evictions.
Сбор метрик в Prometheus устроен так: каждый экспортер отдает их на эндпоинт /metrics, Prometheus забирает по расписанию (обычно раз в 15–30 секунд), а Grafana отображает на графиках. Эта связка покрывает системный мониторинг целиком — без единой строчки кастомного кода команда видит: жив ли сервер, справляется ли база, не задыхается ли PHP.
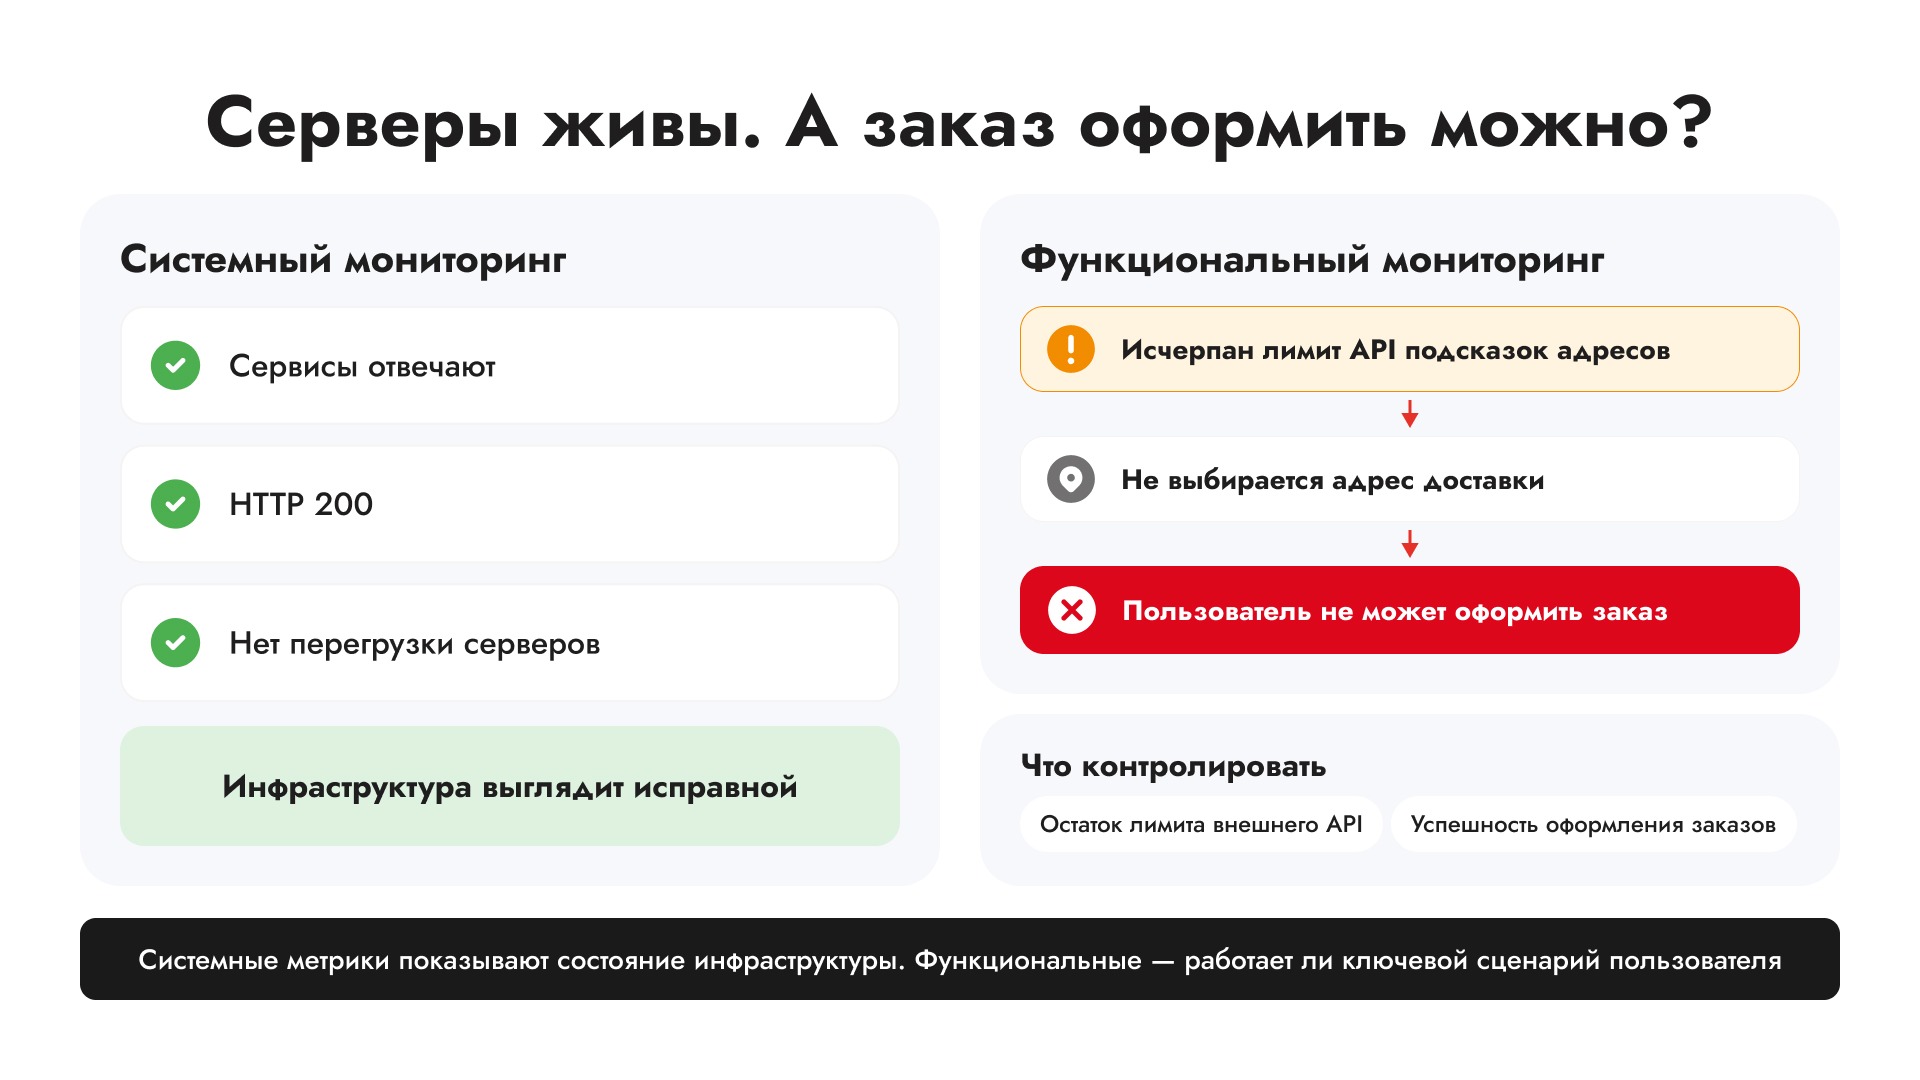 Однако системные метрики не отвечают на вопрос, работает ли бизнес. Сервер может показывать CPU 30%, а каталог товаров — отдавать пустые страницы. Для бизнес-метрик нужен код внутри приложения.
Функциональный мониторинг сайта на примере интернет-магазина
Здесь начинается самое интересное и сложное. Ключевой вопрос — что такое аптайм вашего продукта? Не сервера — именно продукта.
Для e-commerce аптайм — не то же, что «сайт отдает 200 OK». Это когда заказы создаются и оплачиваются, поэтому мониторинг пользовательских сценариев охватывает оба этапа: оформление и оплату заказа. Если заказы просели — у вас инцидент, даже если все серверы зеленые и пингуются. Для других продуктов метрики после запуска выбирают по тому же принципу. Например, для сайта с формой заявки проверяют, дошли ли данные до CRM.
Мы считаем количество заказов одним из ключевых показателей. На нем во многом базируется SLA. Чтобы отсечь естественные колебания — выходные, праздники, маркетинговые акции, — мы берем среднее арифметическое за сегодня, вчера и такой же день неделю назад. Сравниваем отклонение в процентах. Если падение больше 30% от базы — это алерт, по которому включается команда.
Метрики можно снимать двумя способами:
- Сверху вниз — с балансировщика или из логов. Например, берем эндпоинт каталога и считаем долю 200-х ответов относительно других. В норме это около 98%. Если 500-е ошибки начинают расти — это реальная проблема бэкенда. 404 и 301 мы не считаем — это не ошибки сервера, это логика роутинга или отсутствие страницы.
- Снизу вверх — приложение само пишет в систему метрики. Когда поиск успешно отработал — код инкрементирует счетчик. Когда авторизация прошла — получаем +1. Это точнее, но требует осознанных изменений в коде.
Для PHP-стека подключается библиотека promphp/prometheus_client_php, и разработчик описывает, что именно считать:
// Счетчик успешных заказов
$orders = $registry->getOrCreateCounter(
    'business',
    'orders_total',
    'Количество оформленных заказов',
    ['status']  // метка: success / failure
);

// При каждом заказе
$orders->incBy(1, ['success']);
Prometheus забирает эти метрики точно так же, как системные. В Grafana строится график с заказами в минуту, и на него вешается алерт. Если за последние 30 минут заказов стало на 30% меньше, чем обычно в это время — значит, что-то пошло не так. Такой подход меняет оптику мониторинга, ведь теперь мы следим не за серверами, а за бизнесом и его ключевыми процессами.
Многие команды попадают в ловушку «ложных нулей». Допустим, вы мониторите количество успешных авторизаций и видите ноль. Инцидент? Не факт, может, на сайте просто никого нет, потому что три часа ночи.
Мы предпочитаем считать не абсолютные значения, а проценты — например, процент успешных авторизаций относительно попыток. В норме это около 80%. Если этот процент падает, значит, нужно расследовать. Возможно, сломалась капча, протухли ключи шифрования или есть другие причины.
То же самое с SMS-рассылками, с лимитами внешних API, с очередями. Мониторьте не «в штуках», а относительно нормы или количества попыток.
Пороги, шум и кнопка Mute
Шум в мониторинге растет постоянно — это не баг, а фича, в этом суть качественного мониторинга. После каждого инцидента вы добавляете новую метрику, чтобы такое не повторилось. Через год-два жизни крупного проекта у вас может быть 200+ специфических метрик. Спрашивается, как не утонуть в алертах. Мой рецепт — кнопка Mute. Это шутка, но только отчасти.
На самом деле снижать шум нужно системно и волнами:
- Работа с порогами. То, что было критичным год назад, сегодня может быть нормой. Повышайте пороги срабатывания, если бизнес это позволяет.
- Отказ от устаревших метрик. Продукт развивается, архитектура меняется, старые метрики теряют смысл.
Для примера, мы мониторили процент CPU на серверах. Для монолитной архитектуры это критично — если CPU забит, запросы выстраиваются в очередь, начинаются микрозадержки, растет tail latency, и это может убить пользовательский опыт. Когда мы переехали на контейнеры и Kubernetes, превышение CPU в одном поде перестало быть проблемой — оркестратор просто поднимал еще один под. Метрику можно было спокойно выбросить, что мы и сделали.
Если шума стало очень много, и за ним невозможно следить — проблема не в мониторинге. Проблема в здоровье самого продукта — нужно идти в код и архитектуру, рефакторить. Мониторинг — лишь зеркало.
Как выбрать пороги срабатывания алертов
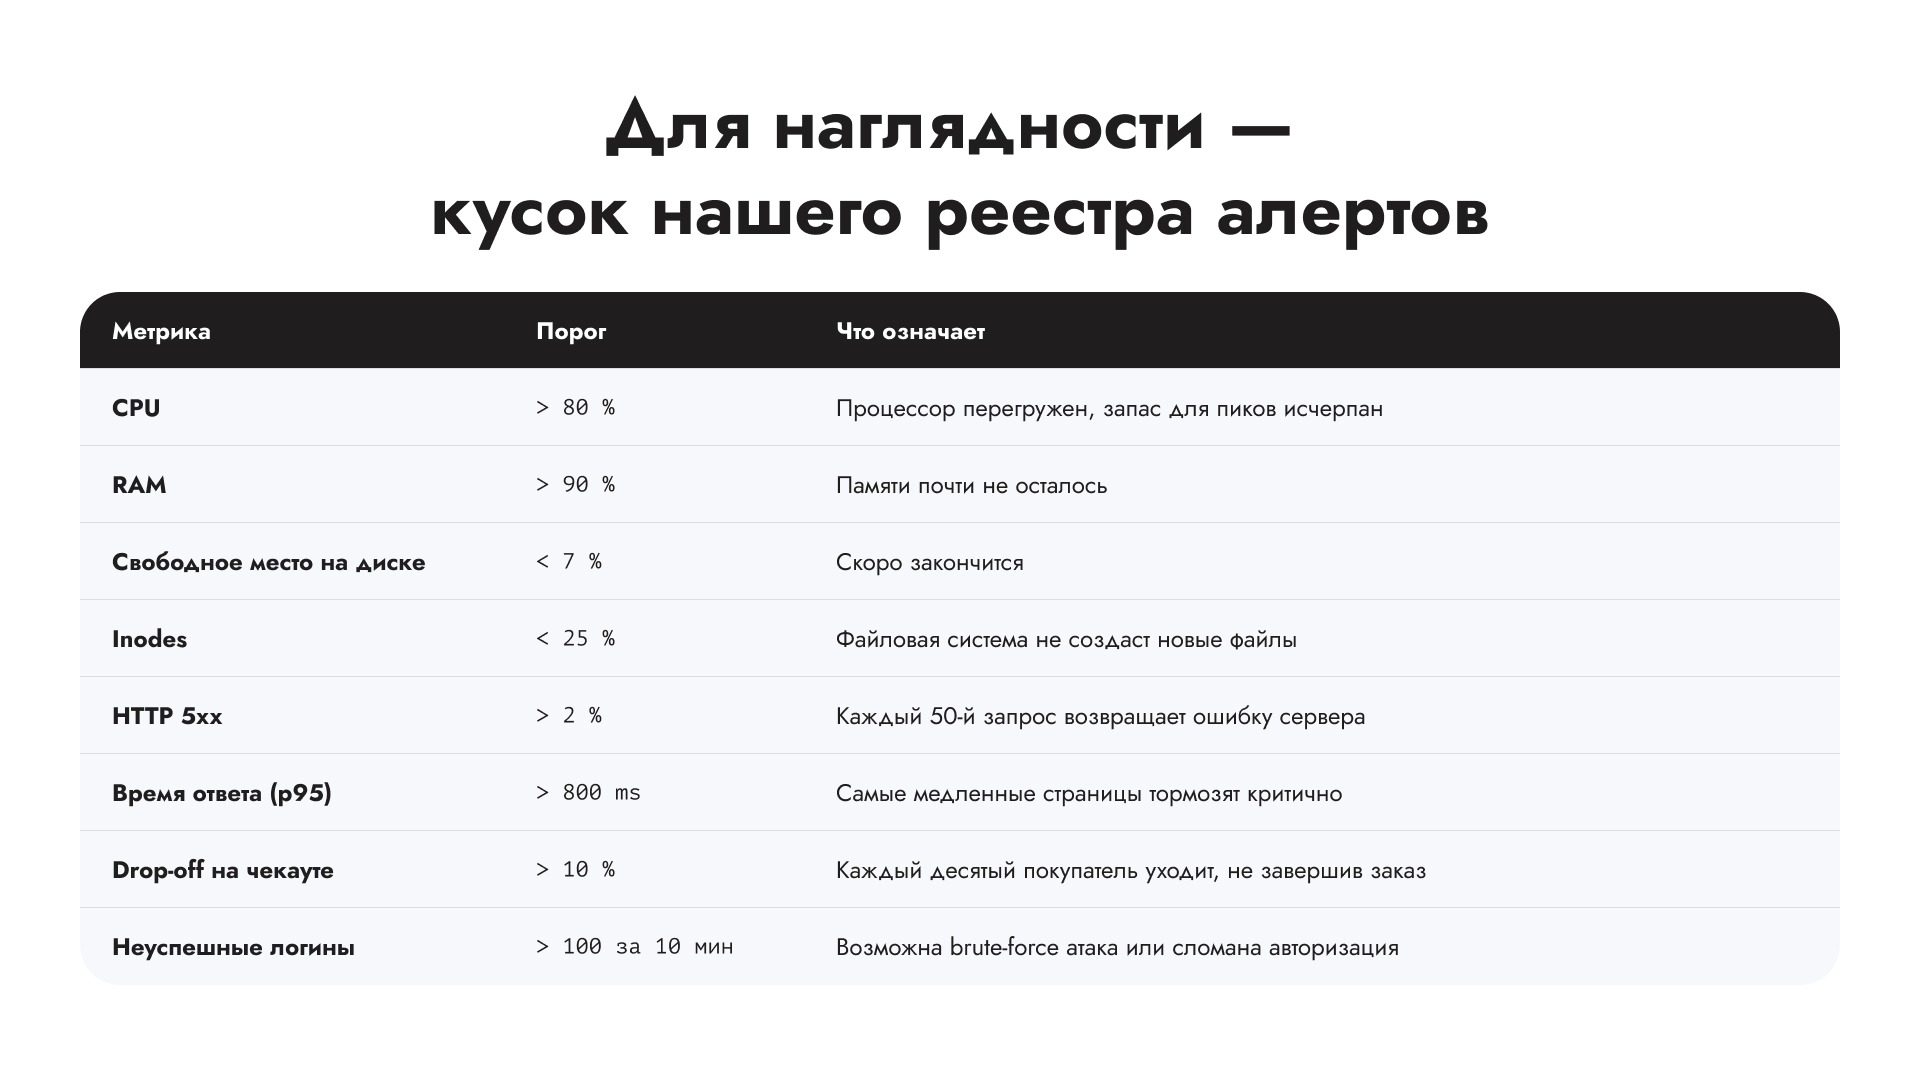
Настройка алертов меняется вместе с проектом. Откуда берутся конкретные числа — CPU > 80%, падение заказов > 30%, успешность каталога > 98%? Пороговые значения появляются на основе трех источников.
- Индустриальные стандарты — стартовая точка. CPU > 80% — классический порог для веб-серверов. При такой нагрузке еще остается запас для пиковых всплесков, но если не среагировать, следующий всплеск уронит сервис. RAM > 90% и свободное место на диске < 7% — из той же логики — оставить буфер, пока еще есть время.
- Исторические данные — следующий уровень. Падение заказов на 30% — это порог, ниже которого сезонные колебания не опускаются. Если заказы упали на 15%, это просто вторник, а если на 35%, что-то сломалось. Где именно провести границу, подсказывает история о том, как метрика вела себя последние полгода, какие были минимумы и максимумы в нормальном режиме.
- Постмортемы — разборы сбоев после восстановления сервиса — помогают корректировать пороги. После каждого инцидента мы их пересматриваем. Пропустили проблему — снижаем порог, чтобы алерт сработал раньше. Замучили ложные срабатывания — поднимаем, чтобы дежурный не распылял внимание и не терял чувствительность к уведомлениям.
Как устроено реагирование на ИТ-инциденты
Мониторинг без регламента реагирования — просто красивые графики. Алерт должен куда-то прилетать, кто-то должен его увидеть и среагировать по готовому плану действий.
У нас алерт приходит в Telegram с графиком из Grafana. Дежурный видит контекст проблемы сразу, без переключения между вкладками.
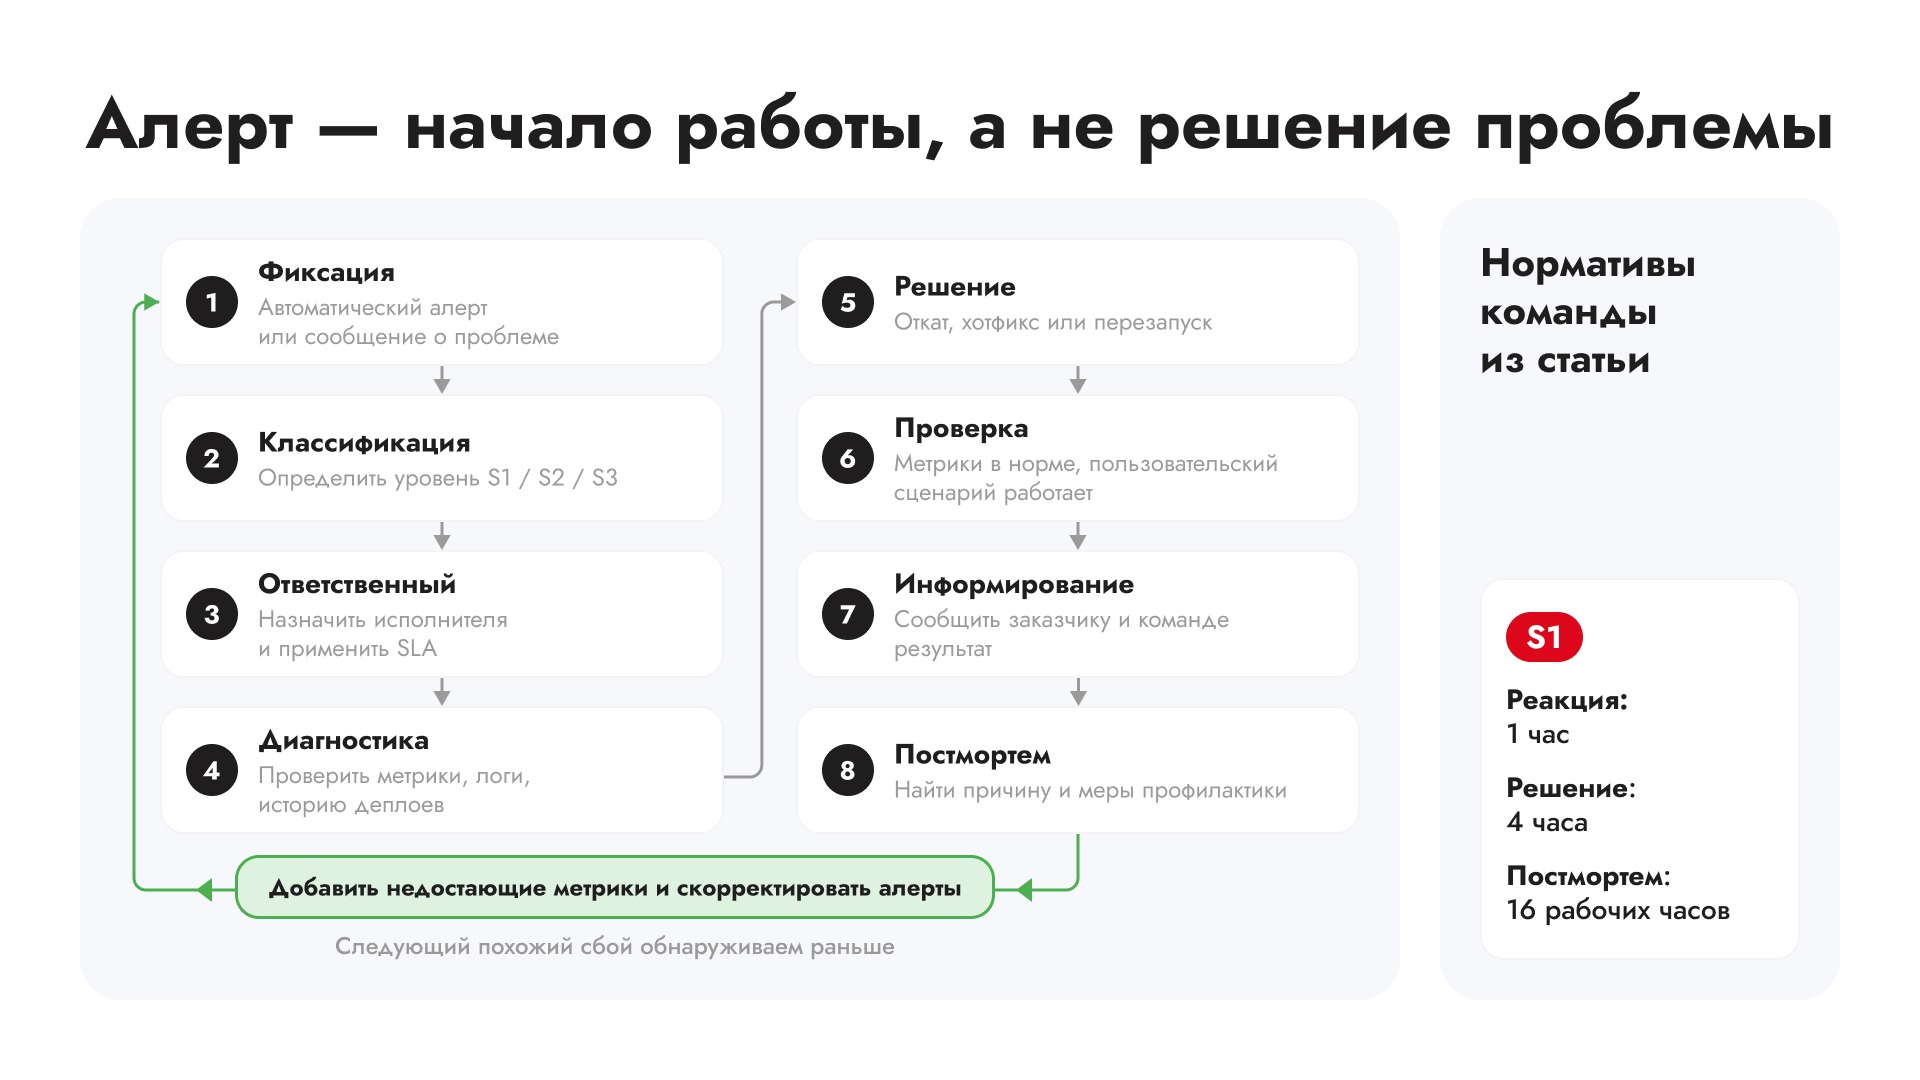 Инцидент проходит восемь шагов:
- Фиксация. Алерт срабатывает автоматически (Prometheus видит, что метрика вышла за порог) или приходит вручную — пользователь или заказчик сообщает о проблеме.
- Классификация. Инциденту присваивают уровень severity: S1 (критический — сервис лежит целиком), S2 (серьезный — ключевая функция деградировала), S3 (умеренный — проблема есть, но основной сценарий работает).
- Назначение ответственного. Время реакции по SLA зависит от уровня критичности: для S1 — 1 час, время решения — 4 часа. В регламенте сопровождения сайта по SLA заранее определяем, когда передавать инцидент следующей линии поддержки и кто сообщает заказчику о ходе работ.
- Диагностика. Дежурный инженер смотрит дашборд, логи, историю деплоев.
- Решение. Откат, хотфикс, перезапуск сервиса — зависит от причины.
- Проверка. Метрики вернулись в норму? Пользователи это подтверждают?
- Информирование. Заказчик и внутренняя команда получают отчет: что случилось, когда починили, что будет дальше.
- Постмортем. Для S1 — обязателен. Срок подготовки — 16 рабочих часов. Это не формальность, а механизм, который не дает наступить на те же грабли.
Кто дежурит
Система включает три роли: дежурный менеджер (координирует и общается с заказчиком), дежурный специалист (разбирает заявки), дежурный инженер (копается в инфраструктуре).
Роль дежурного инженера — переходная. Ее вводят, когда проект получает статус «нестабильный». Критерии четкие: один S1-инцидент за месяц, или S2 за две недели, или S3 за неделю. Пока проект стабилен — дежурного инженера нет, хватает стандартной команды поддержки.
Часы наблюдения — с 9:00 до 23:00. Ночью алерты копятся, утром дежурный разбирает очередь.
Что показывает дежурному дашборд мониторинга в Grafana
Типовой дашборд системного мониторинга — 12 панелей на одном экране:
- Apache — статус (UP/DOWN) и график worker statuses.
- Memcached — аптайм и процент использования памяти.
- MySQL — аптайм и график запросов. Если аптайм показывает 5 минут красным — база только что перезапустилась, и это видно сразу.
- CPU — загрузка с разбивкой: system, user, iowait, IRQs. Не просто 80%, а видно, что именно грузит.
- Память — RAM total, used, cache+buffer, free, SWAP. Если SWAP начал расти — система скоро начнет тормозить.
- Диски — заполнение по разделам + отдельная панель Inodes.
- SSL — срок действия сертификата. Gauge показывает «12.6 weeks» — есть почти три месяца до истечения. Спасает от ситуации, когда сертификат протух в пятницу вечером.
- HTTP status code — текущий код ответа сайта.
- Backup — время с последнего бэкапа. Если число растет больше суток — бэкапы сломались.
Один экран, 12 панелей, 30 секунд на беглую проверку. Дежурный открывает дашборд утром и за полминуты понимает, все ли в порядке.
Восемь принципов, на которых все держится
За годы работы мы сформулировали восемь правил реагирования:
- Командная работа. Не ждать, пока кто-то один разберется. Собираем всех ответственных, каждый знает свою роль.
- Прозрачность. Все участники получают максимум деталей сразу: характер инцидента, последствия, что от кого ожидается.
- Скорость. Чем быстрее приступили — тем быстрее сайт снова доступен. Без регламента можно потратить кучу времени только на выяснение, кто этим занимается.
- Влияние на другие задачи. Инцидент S1 сдвигает сроки других задач — и это нормально. Приоритеты пересматривают сразу.
- Не только причина, но и последствия. Починить сервер мало. Нужно восстановить данные, проверить целостность, убедиться, что ничего не потерялось.
- Документирование. Детальный разбор того, что случилось, почему, как предотвратить в будущем.
- Обучение. После каждого инцидента — разбор с командой. Не ищем виноватого, а выясняем, что не предусмотрели.
- Коммуникация. Заказчик не должен узнавать о проблемах из соцсетей. Связь — проактивная и прозрачная.
Постмортем инцидента и шесть вопросов для команды
Постмортем инцидента — это механизм, который делает мониторинг лучше после каждого сбоя. Для S1-инцидентов он обязателен, срок — 16 рабочих часов, это жесткий SLA.
Есть шесть вопросов, на которые отвечает постмортем:
- Что произошло? Хронология от первого алерта до полного восстановления. Примерно так: «В 14:32 сработал алерт CPU > 85% на prod-web-02, в 14:35 дежурный инженер увидел уведомление в Telegram, в 14:38 подтвердил — нагрузка реальная, не аномалия мониторинга». Минуты, имена алертов, конкретные метрики.
- Почему это произошло? Анализ причин инцидента — здесь помогает метод «5 почему». Сервер упал → потому что закончилась память → потому что PHP-процессы не освобождали соединения с базой → потому что пул соединений не был ограничен → потому что при миграции на новую версию забыли перенести конфиг. Пять вопросов — и вместо бесполезного «сервер упал» мы видим конкретный пробел в процессе.
- Как устранили? Шаги решения: кто подключился, какой откат или хотфикс применили, сколько времени заняла каждая фаза. Это инструкция для следующего дежурного, которому достанется похожая ситуация.
- Сколько времени заняло? От момента алерта до закрытия инцидента, время измеряется отдельно для каждого уровня severity. S1, S2, S3 имеют разные нормативы, и тренд по этой метрике показывает, работает ли команда быстрее.
- Как предотвратить? Конкретные action items, например, добавить алерт на размер пула соединений, поменять порог CPU с 85% на 80%, внести проверку конфигов в чек-лист деплоя. Каждый item — с ответственным и дедлайном.
- Покрыл ли мониторинг этот случай? Самый важный вопрос, потому что если алерт сработал вовремя — мониторинг справился. Если проблему нашел заказчик — мониторинг провалился, и нужно добавить правило, которое в следующий раз поймает такой же сбой раньше. Именно этот пункт замыкает цикл: инцидент → постмортем → улучшение мониторинга → следующий инцидент ловим быстрее.
У мониторинга нет дедлайна. Это живой организм, с которым нужно работать так же регулярно, как с тестами или CI/CD.
Два хака, которые экономят нервы
1. Агрегированная метрика быстродействия
В сервис-ориентированной архитектуре одна страница делает десятки запросов к разным микросервисам. Главная страница может дергать 20 эндпоинтов одновременно. Отслеживать каждый из 500 методов бэкенда нереально, вы утонете в графиках.
Мы сделали агрегированную метрику — суммируем время работы всех запросов, которые браузер делает при загрузке страницы. Технически это не совсем корректно, так как запросы выполняются параллельно, а не последовательно, но в качестве быстрого индикатора «быстрее/медленнее» работает отлично.
Если вчера главная отвечала за 1 секунду, а сегодня за 1,5 — мы идем смотреть, какой из 500 методов деградировал. Заказчик периодически спрашивает: «Почему у вас корзина замедлилась?», и мы можем ответить за минуты, а не за дни расследований.
2. Google PageSpeed прямо в Grafana
Есть опенсорсные решения, которые позволяют снимать метрики PageSpeed Insights и складывать их в Grafana. Это суперудобно — вы в динамике видите скорость десктопа и мобилки, главной, каталога и карточки товара…
Можно повесить алерт: «PageSpeed просел». Это значит, что через несколько месяцев у вас упадут позиции в поиске, снизятся продажи и далее по цепочке. В итоге маркетологи и сеошники скажут вам спасибо.
ИИ как второе мнение (и почему мы не доверяем ему продакшен)
Статья была бы не статья, если бы в ней не было ИИ. Мы собрали агентскую систему на базе LangGraph, которая подключается к мониторингам, логам, индексирует кодовую базу и строит графы кода. Когда происходит инцидент, эта система помогает расследовать причины.
Под капотом работает команда из нескольких моделей: GLM 5.3 для глубокого анализа, DeepSeek 4.1 Flash для выполнения инструкций и написания отладочного кода, в узлах, требующих быстрого решения, местами стоит Qwen. Эмбеддинги кода и документации считаем на Qwen Embedding.
Раньше расследование сложного инцидента занимало часы. Нужно было поднять логи, посмотреть изменения в кодовой базе за последний релиз, понять влияние конкретных задач. Сейчас система проходит этот цикл примерно за 15–20 минут: полное сканирование логов, дифф кода, анализ релизного цикла.
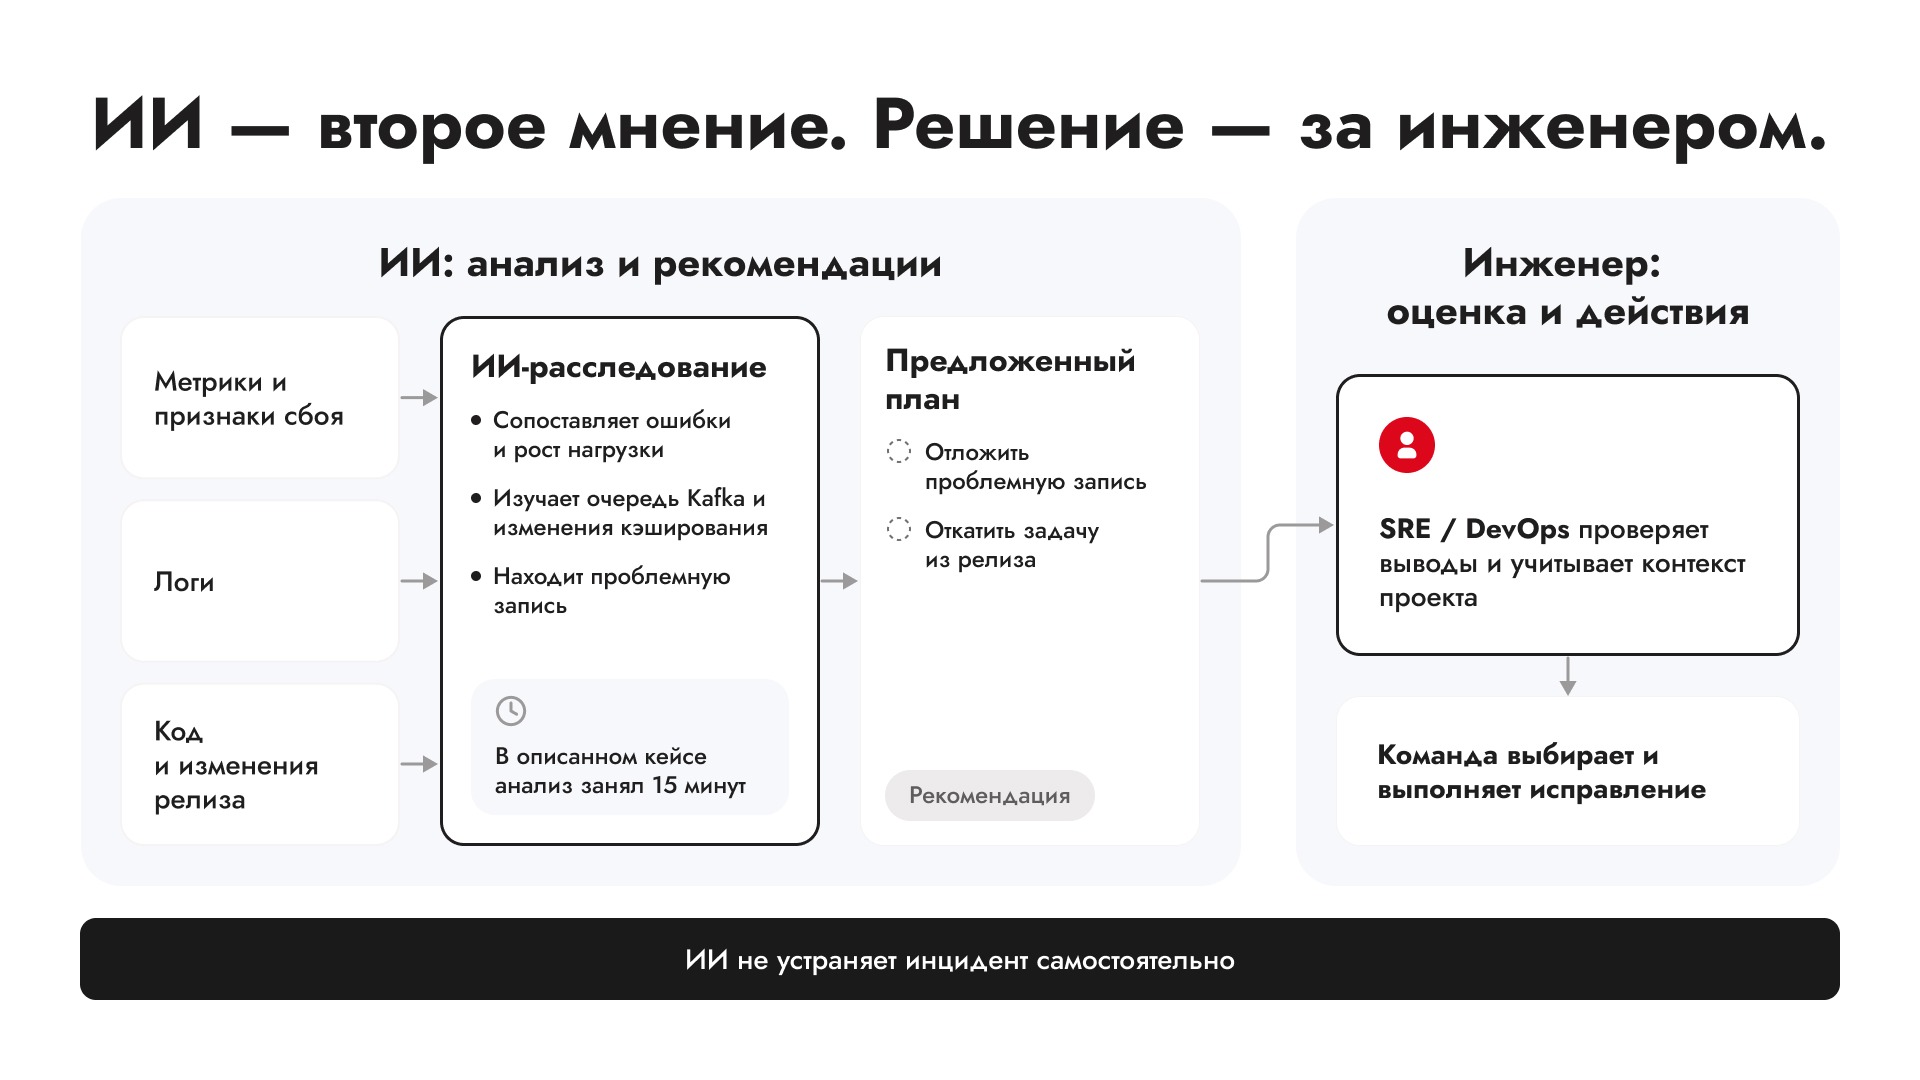
У нас есть реальный кейс — через час после релиза получаем инцидент. Видим, что растет нагрузка на определенные поды, не разбирается очередь Kafka. Скармливаем эти признаки агенту. За 15 минут он изучает консьюмеров и продьюсеров этой очереди, поднимает дифф релиза и находит одну задачу, в которой изменился механизм кэширования. Затем вычисляет конкретную запись в Kafka, которая уходит в цикл с превышением таймаута и пожирает память. Для этого модель сравнивает временные интервалы появления ошибок и роста графиков — то есть делает то же, что делает инженер при ручном разборе. На выходе — готовый план: отложить битую запись, откатить проблемную задачу из релиза. Бонусом агент предложил несколько точек для оптимизации кода.
Но мы не отдаем ИИ устранение инцидентов. Он только расследует и дает второе мнение SRE или девопсам, потому что ИИ понимает только семантику. Он выполняет строго то, что написано в документации и коде, а человек понимает широкий контекст и полутона, помнит то, что случилось три года назад и не описано в доках.
Пока проект не описан на 100% машиночитаемым образом со всеми edge-cases (а таких проектов в природе не существует), ИИ будет оставаться ассистентом, а не автопилотом. Принцип Human in the Loop — это база, и, думаю, в ближайшие годы ею и останется.
 То, что LLM умеет изучать ошибки — не новость. Круто, что в правильной обвязке, как у нас, модель работает насквозь: от требований и системной аналитики до инфраструктуры и кода.
Как говорить с бизнесом и почему разработчик — не продакт
Когда мы заходим на новый проект, мы задаем бизнесу несколько вопросов:
- Что для вас критично? Как вы понимаете, что случилась проблема?
- Что часто ломается? Что вас уже достало?
- И для калибровки — сколько человек уволят, если это не заработает?
Последний вопрос звучит цинично, но он помогает расставить приоритеты. На сайте может слегка «поехать» сортировка товаров — это неприятно, но из-за этого не поднимают команду ночью. А вот остановка процессинга — это инцидент уровня S1, и метрики под него должны быть соответствующими.
Одна из вечных загадок вселенной — как научить разработчиков думать бизнес-функциями. Ответ — никак, я годами пытаюсь — не получается. И, честно говоря, если ваш разработчик думает бизнес-функциями и продуктом — это не разработчик. Это невыявленный тимлид или продакт, и его срочно нужно повышать.
Разработчик выполняет функцию. Он может предложить неочевидное техническое решение, заметить расхождение данных в коде… Но логику мониторинга должен формулировать руководитель проекта или техлид в виде ТЗ. Ставить задачу на мониторинг заказов в надежде, что разработчик сам догадается, как это сделать правильно, — путь в никуда.
Что в итоге
- Инвентаризируйте службы и накатите boilerplate — это закроет системные проблемы.
- Определите ключевую бизнес-функцию — она и есть реальный аптайм.
- Считайте проценты, а не абсолютные значения.
- Пишите постмортемы и добавляйте по их итогам метрики.
- Регулярно удаляйте устаревшие метрики, иначе утонете в шуме.
- Регламентируйте реагирование. Алерт без плана действий — просто шум.
Мониторинг, который ловит инцидент раньше заказчика, строится не от серверов к бизнесу, а от бизнеса к серверам. Базовые вопросы к бизнесу на старте закрывают 80% проблем первого месяца. Дальше система растет сама — через инциденты, постмортемы и эволюцию продукта. У мониторинга нет цели. Есть только путь. И пока жив продукт, жив и его мониторинг.
Читайте также: ИИ vs сисадмин: кто будет чинить серверы через 5 лет