

Наличие резервной площадки и актуальных резервных копий принято считать основой отказоустойчивой инфраструктуры. Компании инвестируют в системы резервного копирования, репликацию данных и дублирование критически важных компонентов, рассчитывая минимизировать последствия аварий. Однако на практике даже хорошо подготовленная инфраструктура может восстанавливаться значительно дольше, чем предполагалось изначально.
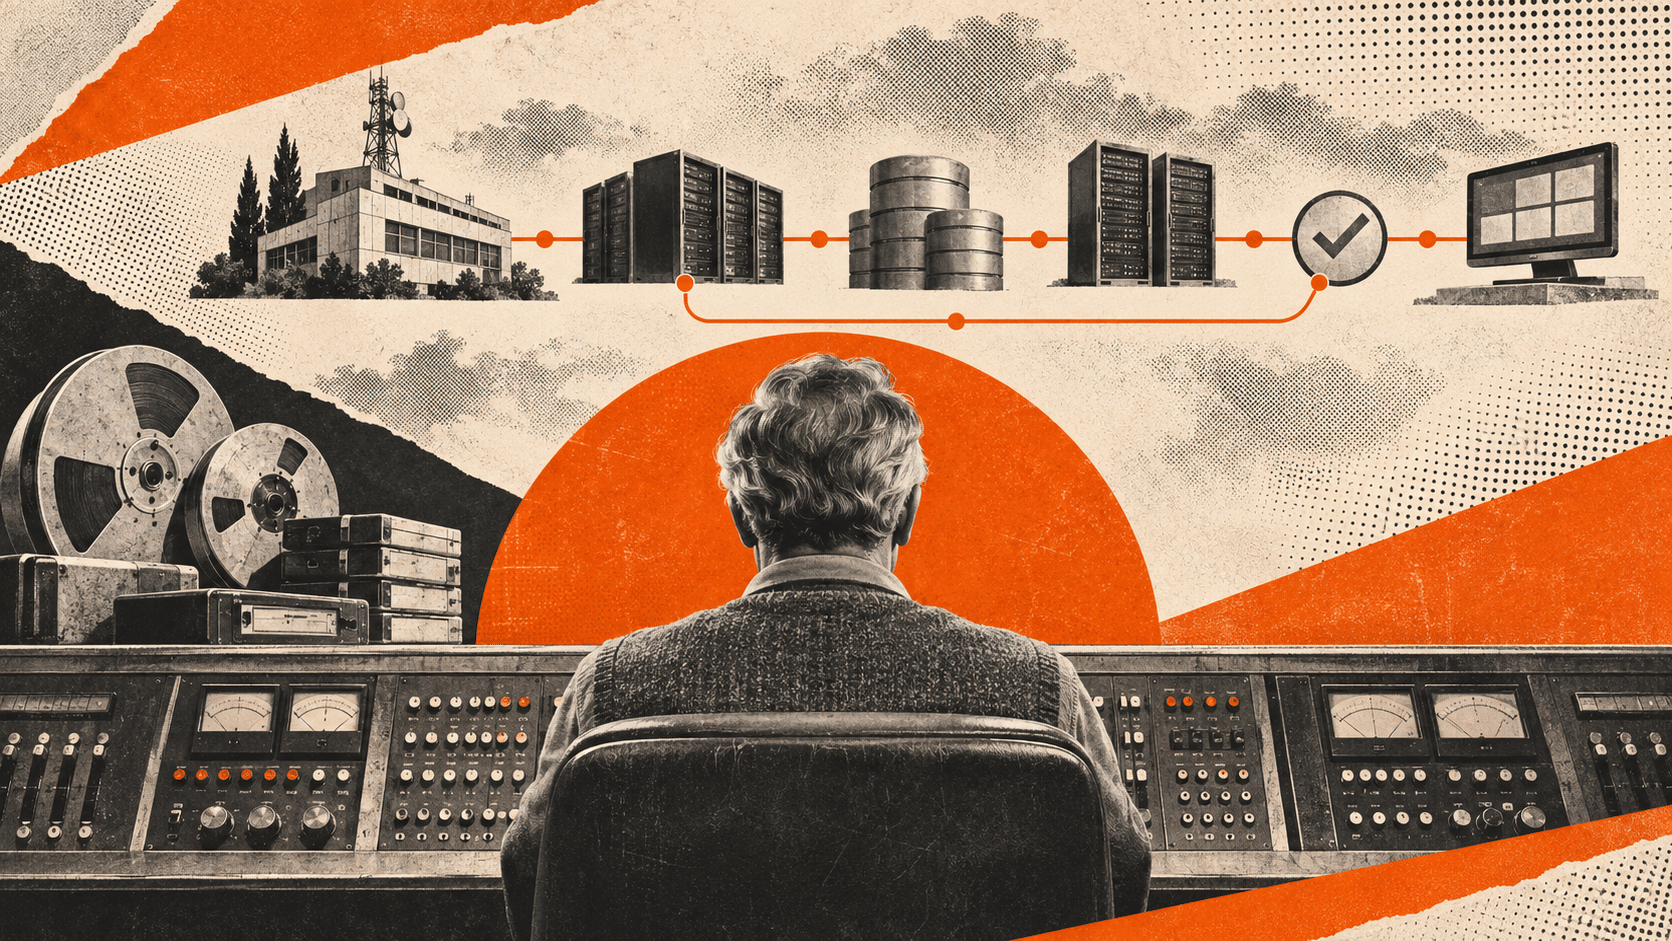 Причина в том, что восстановление данных и восстановление работоспособности ИТ-сервисов представляют собой разные задачи. Чтобы вернуть в строй корпоративное приложение, недостаточно поднять виртуальную машину и восстановить базу данных. Необходимо подготовить вычислительные ресурсы, проверить сетевую связность, запустить зависимые компоненты, убедиться в доступности приложения и только после этого переключить на него пользовательский трафик.
Каждый из этих этапов может требовать участия отдельной команды. Администраторы виртуализации отвечают за вычислительные ресурсы, специалисты по базам данных восстанавливают информацию, сетевые инженеры обеспечивают доступность сервисов, а эксплуатация проверяет работоспособность приложения. Даже если все участники знают свои задачи, согласование последовательности действий и ожидание результатов друг друга увеличивают общее время восстановления.
В связи с этим сегодня все большее значение приобретает автоматизация Disaster Recovery (DR), которая позволяет заранее описать порядок восстановления инфраструктуры и управлять его выполнением из единой системы.
Почему восстановление зависит от порядка действий
Если представить типичную корпоративную систему, состоящую из нескольких серверов приложений, базы данных и сетевых компонентов, то при серьезном сбое основного ЦОД необходимо перенести работу сервиса на резервную площадку.
На первый взгляд задача выглядит простой, ведь достаточно восстановить необходимые ресурсы из резервных копий и запустить приложение. Однако последовательность действий имеет принципиальное значение. Серверы приложений не должны начинать полноценную работу до восстановления базы данных, а переключение пользовательского трафика допустимо только после проверки доступности и корректности работы сервиса.
При этом далеко не все операции необходимо выполнять последовательно. Например, подготовка серверов приложений и восстановление сервера базы данных в определенных условиях могут происходить параллельно. Это позволяет сократить общее время восстановления, но требует корректного управления зависимостями между заданиями.
Дополнительные сложности возникают при ошибках. Если проверка приложения завершилась неудачно, процесс должен остановиться до переключения трафика. Инженерам необходимо получить информацию о проблеме, устранить ее и повторить соответствующий этап. В противном случае попытка ускорить восстановление может привести к дополнительным сбоям.
Именно поэтому в современных подходах к Disaster Recovery все больше внимания уделяется оркестрации. Инженеры заранее определяют, какие действия необходимо выполнить, какие из них могут запускаться одновременно, от каких результатов зависит следующий этап и в каких точках требуется подтверждение ответственного специалиста.
Подобная логика реализуется с помощью платформ автоматизации на базе Ansible. Например, Astra Automation позволяет объединять отдельные задания в управляемые процессы, задавать последовательность их выполнения и учитывать результаты предыдущих этапов. Благодаря этому восстановление инфраструктуры становится воспроизводимым сценарием, который можно подготовить и проверить до возникновения реальной аварии.
От аварийной инструкции к управляемому сценарию
Традиционный план аварийного восстановления нередко представляет собой документ с последовательностью команд, описанием ответственных сотрудников и инструкциями по переключению сервисов. Такой документ необходим, но его практическая ценность во многом зависит от актуальности информации и готовности специалистов правильно выполнить все действия в стрессовой ситуации.
Автоматизация позволяет перенести значительную часть этой логики непосредственно в исполняемые сценарии. В Astra Automation инженеры могут использовать Ansible playbook для описания операций с инфраструктурой, а затем объединять их в единый процесс восстановления. Например, первый этап отвечает за подготовку ресурсов резервной площадки, второй запускает восстановление данных, третий проверяет доступность сервисов, а заключительный выполняет необходимые действия для переключения трафика.
При этом платформа позволяет организовать параллельное выполнение независимых заданий и переходить к следующим этапам после получения необходимых результатов. Если проверка завершилась ошибкой, дальнейшее выполнение можно направить по отдельной ветке или остановить до устранения проблемы.
Отдельного внимания заслуживает разграничение полномочий. Восстановление критически важных систем может включать операции, которые не должны выполняться без соответствующего разрешения. Например, инженер может подготовить и протестировать сценарий, а дежурный специалист — получить право на его запуск без возможности изменять содержимое. Для особо ответственных действий можно предусмотреть дополнительное подтверждение перед продолжением процесса.
Такой подход позволяет сохранить контроль над инфраструктурой даже в условиях аварии, когда скорость принятия решений особенно важна. При этом параметры подключений, учетные данные и разрешения на выполнение заданий определяются заранее, что уменьшает количество ручных операций непосредственно во время восстановления.
Не менее важна прозрачность происходящего. Astra Automation сохраняет результаты выполнения заданий, время их запуска и журналы операций. Если один из этапов завершился ошибкой, команда может определить проблемный участок, изучить подробности и внести необходимые изменения в сценарий.
В результате план восстановления постепенно превращается из набора инструкций в проверяемый технологический процесс, который можно регулярно совершенствовать.
Проверять восстановление нужно до аварии
Еще одна распространенная проблема Disaster Recovery связана с недостаточной проверкой планов восстановления. Резервные копии могут создаваться ежедневно, но полноценное восстановление сервиса на резервной площадке иногда проверяется значительно реже.
Между тем инфраструктура постоянно меняется. Обновляются операционные системы и приложения, появляются новые зависимости, изменяются сетевые настройки и параметры безопасности. Сценарий, который успешно работал несколько месяцев назад, может оказаться неактуальным после очередного изменения конфигурации.
Поэтому важным преимуществом автоматизации становится возможность регулярно проводить тренировочные восстановления. Подготовленный сценарий запускается на тестовой инфраструктуре, после чего специалисты анализируют результаты, выявляют ошибки и корректируют последовательность действий.
В Astra Automation для этого можно использовать историю выполнения заданий и журналы, позволяющие определить, на каком этапе возникла проблема и сколько времени потребовалось на выполнение отдельных операций. После внесения исправлений сценарий можно запустить повторно и проверить результат.
Такой подход особенно важен для организаций с жесткими требованиями к непрерывности бизнеса. Он позволяет заранее обнаруживать проблемы, которые при ручном восстановлении могли бы проявиться только во время реальной аварии.
При этом автоматизация не отменяет необходимости определять целевые показатели восстановления. RTO, то есть допустимое время восстановления сервиса, зависит не только от скорости выполнения сценариев, но и от готовности резервной площадки, производительности систем хранения и других компонентов. Аналогично RPO, определяющий допустимую потерю данных, во многом зависит от выбранной схемы резервного копирования и репликации.
Задача платформы автоматизации заключается в том, чтобы сократить задержки, связанные с ручными действиями, обеспечить соблюдение последовательности операций и сделать процесс восстановления более предсказуемым.
В конечном счете зрелость Disaster Recovery определяется тем, насколько быстро и надежно организация способна восстановить работу критически важных сервисов в реальных условиях. Резервные копии и резервная инфраструктура создают техническую основу для этого процесса, а платформы вроде Astra Automation позволяют связать отдельные компоненты в единый управляемый механизм.
И чем сложнее становится корпоративная инфраструктура, тем большее значение приобретает возможность не просто восстановить данные, а гарантированно выполнить заранее проверенный порядок действий с минимальным участием человека.
Читайте также: