

Масштабирование ИИ-инструментов часто ограничивается качеством данных. Если они неполные, противоречивые или устаревшие, модель увеличивает количество ошибок в работе бизнеса. Как перестроить дата-платформу, не пропускать «плохие» данные и быстрее создавать аналитические и ИИ-продукты — разбираемся вместе с Михаилом Филимоновым, CTO дата-платформы в компании «Магнит».
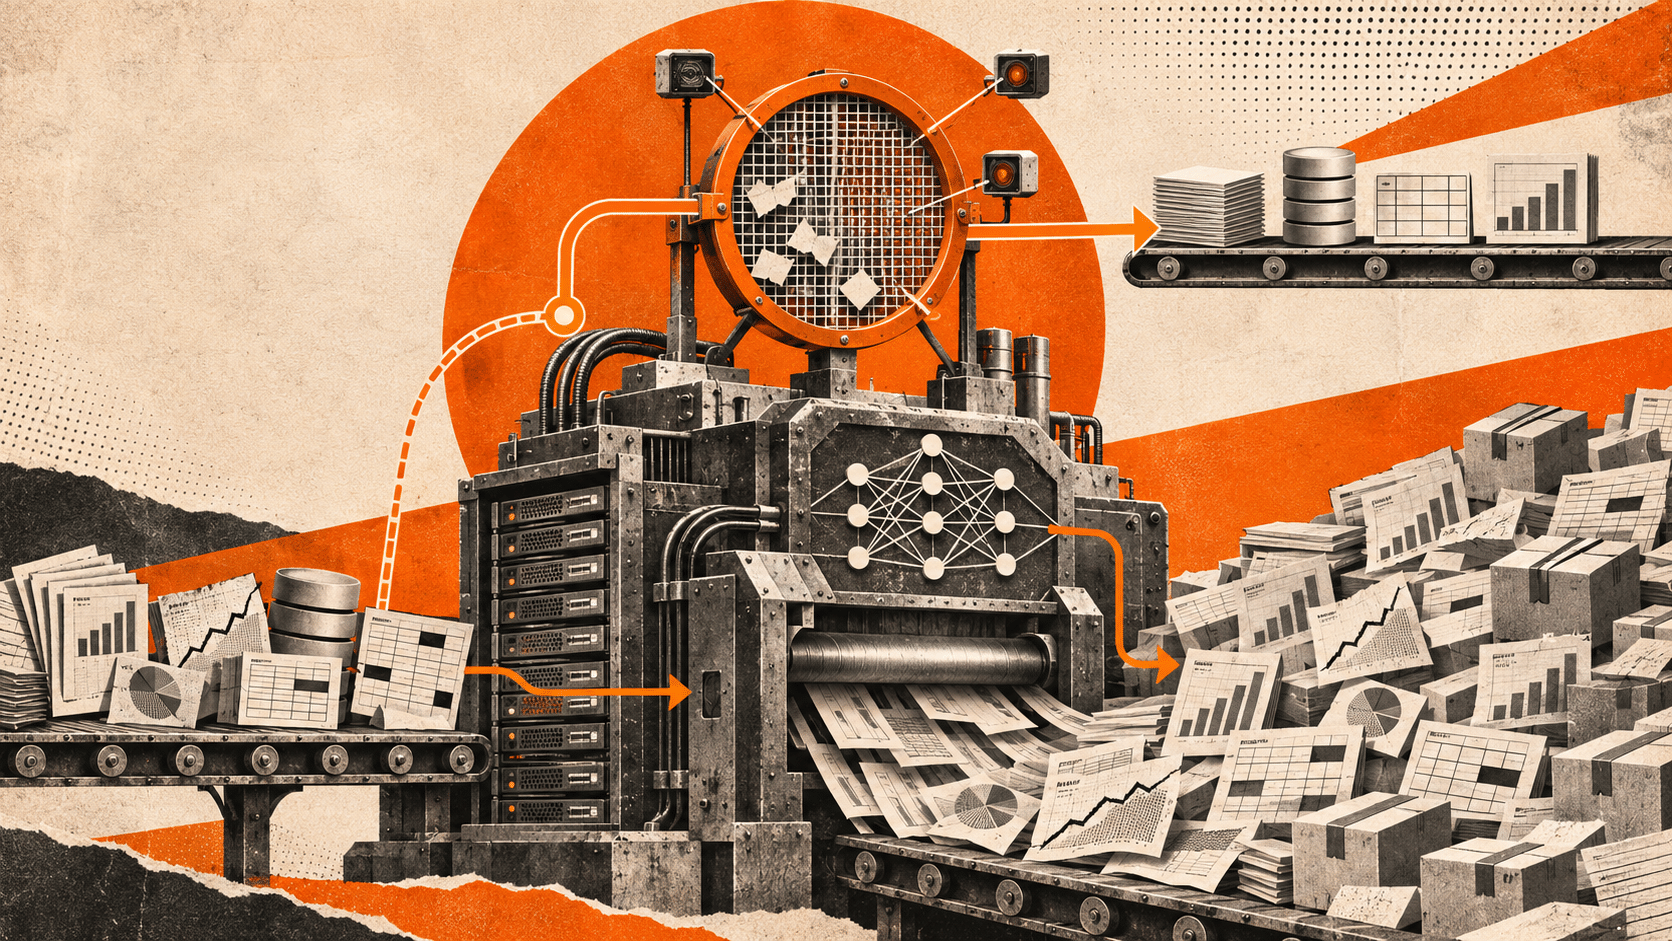
Почему ИИ масштабирует ошибки при «плохих» данных
Представим, что директор торговой компании оценивает результаты промоакции. Два подразделения подготовили отчеты и получили разные цифры, потому что одни учитывали возвраты товаров, а другие — нет.
Когда данных мало и расхождения отслеживаются вручную, команда вовремя заметит и исправит ошибку. Но если на больших объемах данных строится автоматизированный процесс с ИИ, последствия будут серьезнее. Например, модель сделает неверный вывод из ошибочного отчета и переоценит эффективность промоакции, что приведет к закупке лишнего товара.
Чтобы применять ИИ в крупном бизнесе, нужны не только вычислительные мощности и подходящая модель. Необходимо перестроить весь традиционный подход к работе с данными. Это значит: создать единые правила производства данных, назначить ответственных, отслеживать пути информации и обеспечить ее наблюдаемость от источника до результата. Для всего этого нужна трансформация корпоративной дата-платформы.
Когда дата-платформа становится очередью задач
Вместе с ростом бизнеса увеличивается число информационных систем, интеграций, аналитических сценариев и команд, которые пользуются данными. Каждая новая потребность создает дополнительную нагрузку:
- чтобы подключить новый источник, разрабатывают отдельное решение;
- одни и те же показатели рассчитывают в разных доменах по-разному;
- команды создают решения, требующие уникальной поддержки и механизма сбора статистики;
- некачественные данные обнаруживаются, когда они уже попали в отчеты.
Хранилище данных превращается в очередь: бизнес формулирует запрос, аналитики и инженеры передают задачу между собой. Время уходит на согласования, ручные операции и устранение последствий при изменениях. Одновременно растут и расходы на инфраструктуру: дополнительные мощности и избыточные вычисления. При этом связь затрат с результатами для бизнеса проследить сложно.
В такой ситуации улучшить только один компонент дата-платформы — недостаточно. Тогда «узкое место» просто переместится с одного участка на другой. Подход к перестройке платформы должен быть комплексным.
Дата-платформа станет средой, в которой путь от гипотезы до ИИ-продукта будет управляемым и повторяемым. Тогда появятся условия для self-service — команды смогут самостоятельно создавать надежные аналитические и AI-driven продукты без помощи инженеров.
Как трансформировать дата-платформу, чтобы отдавать ИИ качественные данные
Стратегическая цель — организовать путь данных как один процесс от подключения источника до готового отчета, аналитического продукта или решения. Причем ИИ стоит рассматривать как часть общей среды, а не как надстройку поверх платформы.
1. Сформировать единый производственный контур
Дата-платформа должна быть не просто хранилищем данных, а источником надежных результатов с предсказуемыми затратами. Для этого нужно выстроить связи между этапами работы. Сначала подключать источники по общим правилам, описывать структуру данных и условия обновлений. Затем проводить информацию через проверки и отправлять в повторно используемые витрины, где согласованы определения и бизнес-логика. Аналитические команды смогут разрабатывать продукты на этой основе и не делать каждый раз расчеты с нуля.
2. Отслеживать качество данных
Это значит контролировать все этапы жизненного цикла информации. Если источник изменит формат, данные перестанут поступать или показатель выйдет за допустимые границы, отклонение необходимо обнаружить как можно раньше.
3. Устранять причины, а не только последствия
Критические инциденты неизбежны, но их разбор должен вести к изменениям в архитектуре и автоматическим проверкам. Тогда проблема не повторится. Ключевую роль играет не скорость устранения сбоя сама по себе, а снижение количества экстренных ситуаций.
Как делить зоны ответственности в команде при трансформации дата-платформы
Чтобы перестроить платформу, можно выделить пять специализированных команд. Каждая выполняет свои задачи, а вместе они создают общий контур: подключают источники по стандарту, переиспользуют бизнес-логику, автоматизируют эксплуатацию, контролируют качество, а системные проблемы решают на уровне причин.
| Команда | Чем занимается | Какие цели реализует |
| Команда интеграций | Стандартизирует подключение источников: описывает структуру, контролирует изменения, согласовывает правила обновления и требования к доступности. | Помогает переходить от ручной разработки к повторно используемым шаблонам и типовым маршрутам. Обеспечивает скорость, стабильность и прозрачность подключения данных. |
| Команда витрин | Создает инструментарий для единообразной разработки витрин данных. Эти витрины служат строительными блоками для новых аналитических и ИИ-продуктов. | Поддерживает правила для self-service: AI-driven разработку, шаблоны, автоматические проверки, мониторинги. |
| Команда DevOps и DataOps | Отвечает за автоматизацию развертывания, управление конфигурациями, наблюдаемость данных, эффективность вычислительных ресурсов. | Обеспечивает прозрачность инфраструктурных затрат и снижение расходов на дата-продукты. |
| SWAT-команда | Подключается к критическим инцидентам, технологическим блокерам и исследовательским задачам по развитию платформы. | Устраняет проблему и делает так, чтобы она не повторилась: меняет архитектурные шаблоны, внедряет новые инструменты. |
| Команда DQ&DG | Отвечает за качество данных (Data Quality) и управление данными (Data Governance). Создает инструментарий для описаний данных и метрик. | Встраивает проверки качества данных в жизненный цикл продукта: от источника до бизнес-показателей в витрине. |
Как внедрить self-service и не создать хаос
Самостоятельная разработка дата-продуктов позволяет командам решать типовые задачи без инженеров. Но если нет общих правил, появляется проблема: они строят собственные витрины данных и по-разному считают одинаковые показатели. Внедрение self-service требует таких условий:
- Стандартные инструменты и компоненты для разработки. Команды работают с готовыми наборами данных, шаблонами и автоматическими проверками, которые можно использовать повторно. Тогда для каждого продукта не приходится заново подключать источники, разрабатывать логику и настраивать контроль качества.
- Общие определения и прозрачные права доступа. Участники процессов договариваются о значении бизнес-показателей и определяют, кто с какой информацией может работать. Владельцы данных отвечают за их качество и соблюдение согласованных правил.
Основной принцип self-service — свобода без стандартов создает хаос, а стандарты без удобных инструментов создают очередь. При перестройке дата-платформы необходимо совместить оба подхода, чтобы масштабировать ИИ-решения.
Какие метрики покажут, что трансформация дата-платформы работает
Перестройку платформы не стоит оценивать по количеству внедренных технологий или созданных команд. Важен реальный эффект для пользователей и бизнеса. Рекомендуем смотреть на такие показатели:
- Скорость — время подключения нового источника и создания дата-продукта.
- Self-service — доля операций, которые пользователи выполняют через стандартные самостоятельные сценарии.
- Экономика — стоимость хранения и обработки данных в расчете на продукт или нагрузку.
- Повторное использование — доля витрин и компонентов, которые используют сразу несколько команд.
- Управляемость — доля критичных данных с владельцами, правилами качества и наблюдением пути.
- Надежность — частота инцидентов, скорость их обнаружения и устранения.
- AI-ready — доступность новых дата-продуктов для агентов сразу после разработки.
Подведем итоги
ИИ одинаково масштабирует корректные решения и ошибки, поэтому нужно не только выбрать модель, но и обеспечить ее надежными данными, прослеживаемостью результатов и своевременным обнаружением изменений. Тогда внедрение ИИ превратится из отдельного эксперимента в устойчивый инструмент бизнеса.
Перестройка платформы позволяет развивать аналитические и ИИ-продукты. Основу создают стандартизированные интеграции, повторно используемые витрины, автоматизация, владельцы данных и контроль качества.
Дата-платформа должна постоянно улучшаться. Нельзя один раз построить идеальную архитектуру и закрыть задачу. Бизнес-процессы, источники, определения показателей и требования к безопасности регулярно обновляются. Поэтому бизнесу нужна система, которая адаптируется к таким изменениям без резкого роста затрат.