


Новый метод KandiShop работает с уже существующими нейросетями. Качество генерации лиц становится лучше, чем у NanoBanana. Код опубликован в открытом доступе.
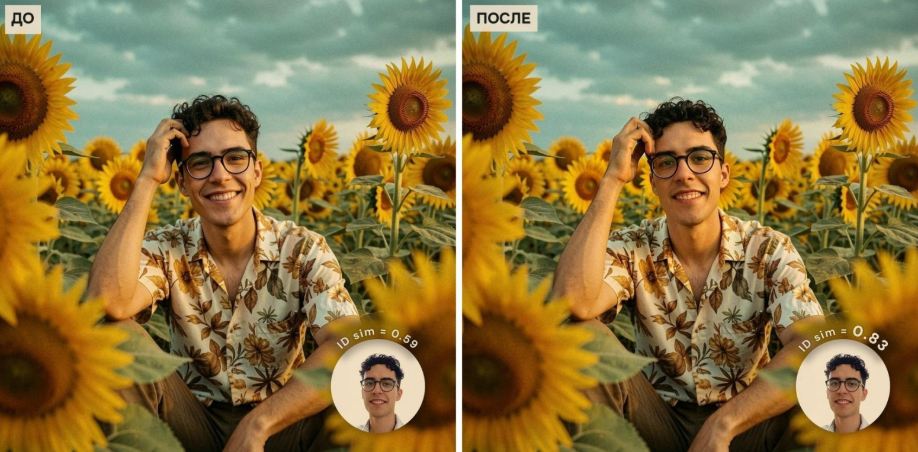
Исследователи Лаборатории FusionBrain Института AIRI нашли способ исправить самый заметный недостаток ИИ-фотосессий. Сейчас лица на таких снимках далеко не всегда получаются идентичными референсу, а мелкие надписи на товарах нередко превращаются в набор закорючек. Новый метод берет готовую картинку и обычную фотографию человека или товара и аккуратно исправляет на картинке только лицо или этикетку.
Нейросети последнего поколения умеют по одной фотографии поместить человека в любую сцену: на пляж, в офис, на обложку журнала. Для этого достаточно загрузить снимок и написать, что нужно получить. Но если показать результат друзьям, часто можно услышать: «Похоже, но это не ты». Цвет волос, форма лица и улыбка на месте, а мелочи, по которым мы на самом деле узнаем людей, теряются. С товарами то же самое. Логотип и цвета упаковки нейросеть рисует правильно, а состав или название мелким шрифтом прочитать уже нельзя. Сегодня любую картинку легко увеличить на экране телефона, поэтому такие огрехи сразу бросаются в глаза.
Исследователи выяснили, откуда берется проблема. Нейросеть одновременно решает две задачи, которые мешают друг другу. С одной стороны, ей нужно придумать новую позу, свет и композицию. С другой — точно скопировать каждую черту лица и каждую букву. Когда эти задачи конфликтуют, нейросеть выбирает общую картинку, а детали размывает. Если же попросить ее просто сделать точную копию фотографии, она справляется почти идеально. Получается, нейросеть умеет сохранять детали, но ей мешает необходимость делать всё сразу.
Поэтому исследователи разделили работу на два параллельных процесса. Сначала программа находит на картинке лицо или товар и увеличивает этот фрагмент, чтобы нейросеть сосредоточилась только на нём. Затем фотография-образец автоматически поворачивается и подгоняется по размеру так, чтобы глаза совпали с глазами, а слова на упаковке легли на те же места. После этого нейросеть перерисовывает фрагмент сразу в двух режимах. Один следит за сценой — позой, фоном и освещением, другой — за тем, как должны выглядеть лицо или надпись. Результаты постоянно сводятся вместе прямо внутри нейросети. В результате лицо не выглядит вклеенным. Оно получает освещение и цвет сцены, но сохраняет собственные черты. В конце исправленный фрагмент возвращается на место, а остальная картинка остается без изменений.
Метод проверили на сотне лиц. Без него открытая нейросеть FLUX.2 klein сохраняла сходство с оригиналом на 52 процента, а с ним — на 75 процентов. У Nano Banana Pro этот показатель составил 57 процентов, у лидера, GPT Image 2 от OpenAI, — 86 процентов. Общее качество и красота картинки при этом не пострадали.
«Наш метод работает поверх уже сгенерированной картинки, и не важно, с помощью какого инструмента она была создана. Метод можно применить и к сгенерированным Nano Banana изображениям, чтобы получить прирост качества с 57 до 76 процентов. Кроме того, на групповых фото каждое лицо обрабатывается отдельно, поэтому черты разных людей больше не смешиваются».
Вера Соболева, научный сотрудник группы «Контролируемый генеративный ИИ» Института AIRI
Отдельно метод испытали на 32 товарах с мелким текстом на упаковке в 320 разных сценах. F1 метрика распознавания текста возрастает с 0.76 до 0.84 у FLUX и с 0.77 до 0.83, если применять метод поверх генераций Nano Banana. Для сравнения у GPT Image 2 – 0.82.
Главное преимущество подхода в том, что нейросеть не нужно переобучать и к ней не нужно подключать дополнительные модели. Метод работает с готовыми системами, и его уже проверили на четырех популярных открытых нейросетях. Версия для FLUX.2 klein опубликована в открытом доступе по ссылке.