

Для обучения нейросети или запуска собственной LLM сегодня достаточно арендовать виртуальную машину с GPU. Однако когда модель переходит в продакшен, требования к инфраструктуре меняются, и тут важно понимать, сколько вычислительных ресурсов ей доступно, выдержит ли она нагрузку и во сколько обойдется круглосуточная работа. В таких условиях компании все чаще рассматривают выделенные GPU-серверы.
В статье разбираемся, какие задачи требуют выделенного физического сервера, чем он отличается от облачного GPU и когда аренда отдельной машины действительно окупается.
Что такое выделенный сервер с GPU
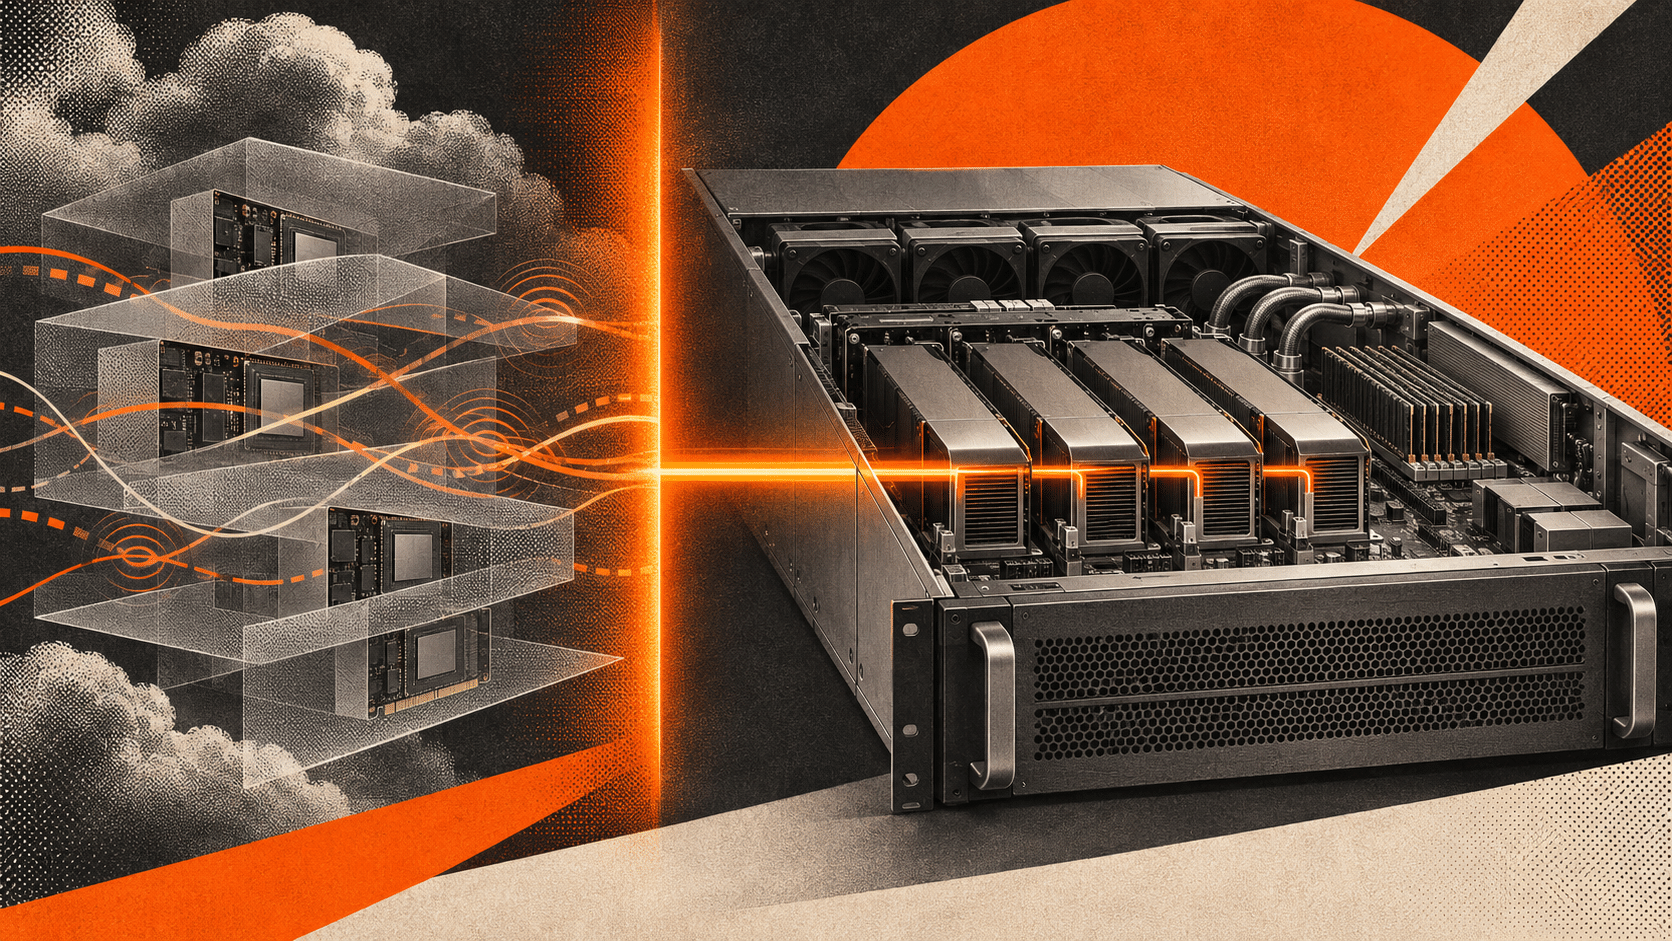
Выделенный сервер с GPU — это физическая машина с графическими ускорителями, которую клиент получает в монопольное пользование. В отличие от облачной виртуальной машины, где ресурсы изолированы на логическом уровне, здесь ускоритель доступен операционной системе напрямую через драйвер, без слоя виртуализации и без соседей, делящих ту же карту.
Доступ к серверу клиент получает через консоль или панель управления провайдера. Дальше стек он собирает сам: устанавливает ОС, драйверы, CUDA-toolkit, ML-фреймворки и системы оркестрации. При необходимости настраиваются ядро ОС, параметры BIOS и сетевой стек под конкретный профиль нагрузки — то, что в виртуализированной среде либо недоступно, либо ограничено гипервизором.
Граница ответственности при этом проходит по железу. Провайдер отвечает за физический уровень: питание, охлаждение, сетевую инфраструктуру, резервирование и замену оборудования при отказах. Клиент отвечает за все, что выше, — от операционной системы до логики приложения.
Что дает аренда выделенного GPU-сервера
Главное преимущество выделенного GPU-сервера — возможность заранее подобрать ресурсы под конкретную нагрузку и пользоваться ими без конкуренции с другими арендаторами. Провайдеры предлагают типовые сборки с разным числом ускорителей, объемом оперативной памяти и конфигурацией хранилища. Для более сложных проектов можно согласовать индивидуальную систему, однако менять ее аппаратную конфигурацию обычно труднее, чем увеличивать ресурсы виртуальной машины в облаке.
Дальше встает вопрос размещения. Выделенный сервер можно разместить в дата-центре провайдера или развернуть на площадке заказчика с интеграцией в существующий ИТ-контур. Второй вариант важен для компаний, которым нужно сочетать производительность с требованиями к физическому размещению данных.
Для таких сценариев и берут выделенные серверы с GPU. При выборе стоит отталкиваться от конкретных параметров (модели ускорителя, числа карт и наличия межкарточного соединения). Например, у ITGLOBAL.COM есть конфигурации с одним NVIDIA RTX PRO 6000 Blackwell Server Edition на 96 ГБ видеопамяти, процессором AMD EPYC 7313 и 128 ГБ оперативной памяти. Для более требовательных задач доступны двухпроцессорные серверы на AMD EPYC 9335 или 9555 с объемом RAM до 1536 ГБ и восемью GPU. Их можно использовать как ориентир.
Когда виртуальный GPU уступает выделенному серверу
GPU в облаке можно получить несколькими способами, и от выбранной технологии во многом зависит поведение приложений. Например, NVIDIA vGPU позволяет распределять ресурсы ускорителя между виртуальными машинами, а MIG выделяет каждому экземпляру собственную часть вычислительных блоков и видеопамяти с аппаратной изоляцией. Есть и PCIe passthrough, при котором целая видеокарта передается одной виртуальной машине. В таком случае соседей по GPU уже нет, хотя сервер по-прежнему работает в виртуализированной среде.
Разница особенно заметна под нагрузкой. Когда несколько виртуальных машин используют один ускоритель с разделением вычислительного времени, активность соседних пользователей может влиять на скорость выполнения задач и задержки. MIG частично решает эту проблему за счет аппаратного разделения ресурсов, обеспечивая более предсказуемую производительность. Поэтому сама по себе виртуализация еще не означает, что приложение будет работать нестабильно.
Ограничения проявляются в более требовательных сценариях. При распределенном обучении моделей важны объем доступной видеопамяти и скорость обмена между ускорителями, которая зависит от топологии PCIe и NVLink. Некоторые CUDA-библиотеки и инструменты также предъявляют требования к драйверам и конфигурации оборудования, а изменить эти параметры в облаке удается далеко не всегда. Выделенный сервер предоставляет больше возможностей для настройки системы, хотя часть таких задач можно решить и на виртуальной машине с GPU passthrough.
При выборе инфраструктуры важно понимать, получает ли приложение часть ускорителя или целую видеокарту, как организован доступ к вычислительным ресурсам и какие настройки разрешает менять провайдер. Эти детали определяют, насколько предсказуемо будет работать нагрузка и оправданы ли дополнительные расходы на физический сервер.
Где заканчивается облако и начинается физический сервер
Физический сервер с GPU дает монопольное использование железа. Разница ощущается в трех типовых сценариях:
- Обучение и дообучение больших моделей. Когда модель распределена между несколькими GPU, ускорителям приходится постоянно обмениваться данными. Здесь важны объем видеопамяти, пропускная способность межкарточных соединений и топология системы. NVLink ускоряет такой обмен, но результат зависит от самой модели и способа распараллеливания вычислений. Добавление новых GPU далеко не всегда приводит к пропорциональному сокращению времени обучения.
- Инференс с жесткими требованиями к задержке. При обслуживании большого количества запросов важна стабильность времени отклика, особенно его верхних значений. Выделенный GPU позволяет исключить конкуренцию с другими арендаторами за ресурсы ускорителя. Однако задержка по-прежнему зависит от размера модели, количества параллельных запросов, настроек батчинга и остальной инфраструктуры.
- Работа с чувствительными данными. Выделенный сервер упрощает контроль над размещением информации и доступом к инфраструктуре. Для компаний, работающих с персональными данными или коммерческой тайной, это может быть дополнительным аргументом. При этом сама физическая изоляция не гарантирует соответствия 152-ФЗ: требования к защите информации, администрированию и обработке данных остаются.
Сравнивать нужно предложения с сопоставимыми GPU и условиями обслуживания, учитывая скидки за длительное использование, стоимость хранения данных и резервирование на случай отказов.
Где физическая изоляция не нужна
Выделенный сервер с GPU нельзя назвать универсальным решением, все же есть сценарии, где он проигрывает облаку. К примеру, это касается пилотов и экспериментов. Если нужно проверить гипотезу на несколько дней, виртуальная машина с GPU запускается быстрее и стоит дешевле. Переводить эксперимент на физический сервер имеет смысл только после подтверждения, что нагрузка устойчива.
При небольших моделях тоже стоит сначала подумать и оценить требования к ресурсам. Инференс компактных моделей не требует монопольного доступа к памяти и шинам, так что будет достаточно виртуализированного ресурса, и переплата за изоляцию не окупается.
Есть и вопрос отказоустойчивости — выделенная машина остается отдельным физическим узлом, и при поломке GPU или другого компонента потребуется ремонт, замена оборудования либо переключение на резервный сервер. В облаке часть таких операций может быть автоматизирована средствами платформы. Правда, здесь тоже все зависит от способа предоставления ускорителей: например, виртуальные машины с GPU passthrough имеют ограничения на живую миграцию.
На что смотреть при выборе
При сравнении предложений аренды серверов с GPU в России стоит смотреть на параметры:
| Критерий | На что обратить внимание |
| Модель GPU и объем видеопамяти | Определяют, какие модели и с каким размером батча можно запускать. Для крупных LLM разница между 96 и 141 ГБ на ускоритель может быть критичной. У российских провайдеров есть конфигурации с разными GPU, от одного до восьми ускорителей. |
| Межкарточное соединение | В системах с несколькими GPU важны топология и скорость обмена данными. Например, NVIDIA H200 NVL поддерживает NVLink, а RTX PRO 6000 Blackwell Server Edition — нет. Это особенно существенно при распределенном обучении моделей. |
| Процессор и оперативная память | CPU и RAM отвечают за подготовку данных и загрузку батчей. Для ресурсоемких задач доступны двухпроцессорные конфигурации AMD EPYC с оперативной памятью до 1536 ГБ DDR5. |
| Диски и сеть | Скорость чтения датасетов и сохранения контрольных точек зависит от накопителей и сетевых интерфейсов. Стоит проверить тип дисков (SSD SATA или NVMe), пропускную способность сети и стоимость дополнительных ресурсов. |
| Размещение сервера | Расположение дата-центра влияет на сетевые задержки, соблюдение требований к размещению данных и доступность технической поддержки. |
| Условия поддержки | Важно уточнить наличие круглосуточной поддержки, регламент замены неисправных GPU, сроки восстановления сервиса и условия SLA. |
Как проверить, нужен ли проекту выделенный GPU
До перехода на физический сервер полезно запустить одинаковую нагрузку в обеих средах. Для инференса стоит измерить пропускную способность в токенах в секунду, время до первого токена (TTFT), задержки на 95-м и 99-м процентилях (p95 и p99), а также загрузку GPU и потребление видеопамяти.
Среднее время ответа здесь малоинформативно, ведь сервис может работать быстро большую часть времени, но периодически задерживать запросы настолько, что пользователи начнут замечать проблему.
При обучении моделей интереснее время одного шага, скорость обработки данных и эффективность масштабирования при добавлении ускорителей. Если переход с двух GPU на четыре почти не сокращает время обучения, стоит проверить обмен между картами, работу с данными и особенности распараллеливания. Покупка или аренда еще большего количества ускорителей сама по себе эту проблему не решит.
Результаты такого тестирования помогут оценить стоимость не только одного GPU-часа, но и выполненной работы, например обработки миллиона токенов или завершения одного цикла обучения. По этим показателям уже можно предметно сравнивать виртуальную и выделенную инфраструктуру.
Выводы
Выделенный GPU-сервер имеет смысл рассматривать, когда нагрузка на ускорители стабильна, приложению нужен полный контроль над оборудованием или существующая виртуальная инфраструктура ограничивает производительность.
Однако сама по себе физическая изоляция не гарантирует ни минимальной задержки, ни экономии. Все решают конкретная конфигурация, характер нагрузки и условия аренды. Перед миграцией стоит провести несколько одинаковых тестов в облаке и на выделенной машине, сравнить полученные результаты и посчитать стоимость эксплуатации.
Иногда окажется, что проекту действительно нужен выделенный сервер с восемью GPU, а иногда достаточно правильно настроенной виртуальной машины.
Читайте также: